<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>yi&#39;s weblog</title>
  
  
  <link href="/atom.xml" rel="self"/>
  
  <link href="http://zhengyi.me/"/>
  <updated>2018-05-22T14:04:09.907Z</updated>
  <id>http://zhengyi.me/</id>
  
  <author>
    <name>Yi</name>
    
  </author>
  
  <generator uri="http://hexo.io/">Hexo</generator>
  
  <entry>
    <title>什么是Argument Dependent Lookup</title>
    <link href="http://zhengyi.me/2018/05/22/what-is-argument-dependent-lookup/"/>
    <id>http://zhengyi.me/2018/05/22/what-is-argument-dependent-lookup/</id>
    <published>2018-05-22T14:00:23.000Z</published>
    <updated>2018-05-22T14:04:09.907Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="引子">引子</span></h2><p>先看一段C++初学者都会写的代码</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">#include &lt;iostream&gt;</span><br><span class="line">#include &lt;string&gt;</span><br><span class="line"></span><br><span class="line">int main(int argc, const char * argv[]) &#123;</span><br><span class="line">    std::string str = &quot;Hello, World!\n&quot;;</span><br><span class="line">    std::cout &lt;&lt; str;   // 1</span><br><span class="line">    std::cout &lt;&lt; &quot;Hello, World!\n&quot;; // 2</span><br><span class="line">    return 0;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>试着回答下面几个问题：</p><ul><li>如果之前学过其他语言但是没接触过C++，代码中<code>&lt;&lt;</code>的写法看起来很怪异，它是怎么工作的？</li><li>1 &amp; 2 的写法有什么不同？它们调用的是同一个方法么？</li></ul><p><strong>回答</strong></p><p>C++中有一个神奇的东西叫做操作符重载，这个操作允许用户针对某一些需要的类型自定义操作符。比如说下面这个数据类型就重载了<code>+</code>号操作符，从而允许更加简单的代码书写形式。这里先不讨论操作符重载带来的问题，但是这个确实是在标准库中被普遍使用的，这里看到的<code>&lt;&lt;</code>也是属于操作符重载。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">class Data</span><br><span class="line">&#123;</span><br><span class="line">public:</span><br><span class="line">    Data&amp; operator+(int i)&#123;std::cout &lt;&lt; &quot;Data+&quot; &lt;&lt; i; return *this;&#125;</span><br><span class="line">&#125;;</span><br><span class="line"></span><br><span class="line">Data d;</span><br><span class="line">d = d + 1;</span><br></pre></td></tr></table></figure><p>我们可以在<code>&lt;ostream&gt;</code>中看到<code>basic_ostream</code>预定义了很多对于<code>operator&lt;&lt;</code>的操作符重载，可以简单的看一下，这里只摘录了一些，头文件中实际定义了更多类型。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">// 27.7.2.6 Formatted output:</span><br><span class="line">basic_ostream&amp; operator&lt;&lt;(basic_ostream&amp; (*pf)(basic_ostream&amp;));</span><br><span class="line">basic_ostream&amp; operator&lt;&lt;(basic_ios&lt;charT, traits&gt;&amp; (*pf)(basic_ios&lt;charT,traits&gt;&amp;));</span><br><span class="line">basic_ostream&amp; operator&lt;&lt;(ios_base&amp; (*pf)(ios_base&amp;));</span><br><span class="line">basic_ostream&amp; operator&lt;&lt;(bool n);</span><br><span class="line">basic_ostream&amp; operator&lt;&lt;(short n);</span><br><span class="line">basic_ostream&amp; operator&lt;&lt;(unsigned short n);</span><br><span class="line">basic_ostream&amp; operator&lt;&lt;(int n);</span><br><span class="line">...</span><br></pre></td></tr></table></figure><p>那么1和2是否都调用了<code>basic_ostream</code>中预定的<code>&lt;&lt;</code>呢？2确实是调用了<code>basic_ostream</code>中的方法，2的代码可以改写成下面这种形式。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">std::cout &lt;&lt; &quot;Hello, World!\n&quot;;</span><br><span class="line">// 相当于</span><br><span class="line">std::cout.operator&lt;&lt;(&quot;Hello, World!\n&quot;);</span><br></pre></td></tr></table></figure><p>但1并不是调用<code>basic_ostream</code>中的方法。<code>basic_ostream</code>中预定义的都是系统自带的类型，而<code>std::string</code>则是标准库自定义的类型，<code>basic_ostream</code>并不知道它的存在。那么<code>std::cout &lt;&lt; str;</code>这行代码是怎么工作的呢？</p><p>我这里先给出答案，然后在慢慢的解释是如何工作的</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">std::string str = &quot;Hello, World!\n&quot;;</span><br><span class="line">std::cout &lt;&lt; str;</span><br><span class="line">// 相当于</span><br><span class="line">operator&lt;&lt;(std::cout, str);</span><br><span class="line">//</span><br></pre></td></tr></table></figure><h2><span id="argument-dependent-lookup实参相关的查找">Argument-Dependent Lookup(实参相关的查找)</span></h2><p>中文翻译参考自C++ Primer，下面简称ADL。这个查找规则简单的可以归纳为：</p><blockquote><p>当我们给函数传递一个类类型的对象时，出了在常规的作用域查找外还会查找实参类所属的命名空间。这个规则对于传递类的引用或指针的调用同样有效。    - 《C++ Primer 5th》</p></blockquote><p>举个例子就能够很直观的看到这个效果。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line">namespace NS </span><br><span class="line">&#123;</span><br><span class="line">   class A &#123;&#125;;</span><br><span class="line">   void f( A &amp;a, int i) &#123;&#125;</span><br><span class="line">&#125;</span><br><span class="line">int main() </span><br><span class="line">&#123;</span><br><span class="line">   NS::A a;</span><br><span class="line">   f( a, 0 );    //calls NS::f</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>有了这个规则以后我们就很好理解本文开头的第一个例子如何工作的。<code>&lt;string&gt;</code>头文件中定一个一个<code>operator&lt;&lt;</code>的操作符重载并且接受<code>basic_ostream</code>为第一个参数，<code>std::string</code>为第二个参数。当编译器在<code>basic_ostream</code>中找不到对应的函数的时候，它便开始在<code>std::string</code>的命名空间下查找对应的方法。然后它找到<string>中有一个符合要求的方法，然后就调用了这个方法。关于C++的命名查找规则是一个巨复杂的东西，有兴趣可以看看这个页面（<a href="http://en.cppreference.com/w/cpp/language/lookup" target="_blank" rel="external">Name Lookup</a>）</string></p><p>同理，我们可以为我们自己的类型自定义这个操作符重载，这样我们在输出的时候就可以更加的方便。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line">class Person</span><br><span class="line">&#123;</span><br><span class="line">public:</span><br><span class="line">    std::string name;</span><br><span class="line">    int age;</span><br><span class="line">&#125;;</span><br><span class="line"></span><br><span class="line">std::ostream&amp; operator&lt;&lt;(std::ostream&amp; os,</span><br><span class="line">                         const Person &amp;p)</span><br><span class="line">&#123;</span><br><span class="line">    os &lt;&lt; &quot;name: &quot; &lt;&lt; p.name &lt;&lt; &quot; age: &quot; &lt;&lt; p.age;</span><br><span class="line">    return os;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">Person p&#123;&quot;john&quot;, 100&#125;;</span><br><span class="line">std::cout &lt;&lt; p &lt;&lt; std::endl;</span><br></pre></td></tr></table></figure><h2><span id="关于adl我们需要注意什么">关于ADL我们需要注意什么</span></h2><p>能够被ADL找到的非成员方法应该被视为类的设计的一部分，如果你考虑写类似的方法如果不是为了ADL的话应该避免这种写法。</p><p>ADL能够极大的方便我们编码时候的方法调用，从而提高代码的可读性。STL库内使用的<code>swap</code>方法也广泛的使用了这个技术。关于swap的话题，改天单独讨论。</p><h2><span id="参考资料">参考资料</span></h2><ul><li><a href="https://stackoverflow.com/questions/8111677/what-is-argument-dependent-lookup-aka-adl-or-koenig-lookup" target="_blank" rel="external">Stackoverflow - What is “Argument-Dependent Lookup” (aka ADL, or “Koenig Lookup”)?</a></li><li><a href="http://www.gotw.ca/gotw/030.htm" target="_blank" rel="external">GotW #30 - Name Lookup Herb Sutter</a></li><li><a href="https://www.wikiwand.com/en/Argument-dependent_name_lookup" target="_blank" rel="external">Argument-dependent name lookup wikipedia</a><br>-</li></ul>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;引子&quot;&gt;引子&lt;/span&gt;&lt;/h2&gt;&lt;p&gt;先看一段C++初学者都会写的代码&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="C++" scheme="http://zhengyi.me/tags/C/"/>
    
  </entry>
  
  <entry>
    <title>《C++ Concurrency In Action》读书笔记 - 如何设计并发代码</title>
    <link href="http://zhengyi.me/2018/05/10/cpp-concurrency-in-action-reading-notes-how-to-design-concurrent-code/"/>
    <id>http://zhengyi.me/2018/05/10/cpp-concurrency-in-action-reading-notes-how-to-design-concurrent-code/</id>
    <published>2018-05-10T14:21:37.000Z</published>
    <updated>2018-05-22T13:58:55.265Z</updated>
    
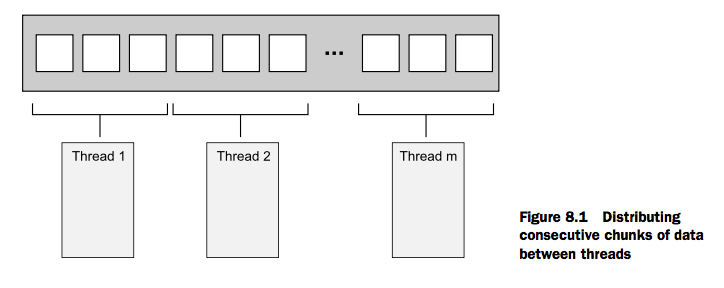
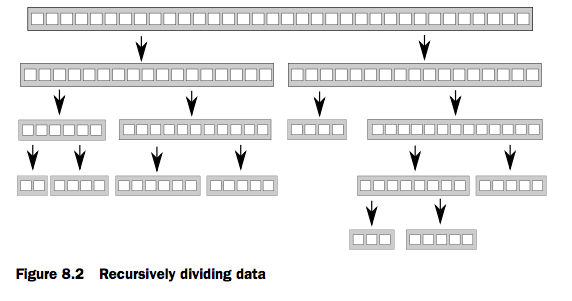
    <content type="html"><![CDATA[<p>这本书前面几章介绍了C++并发编程中使用到的一些具体工具，掌握了这些具体工具并不能够保证你能够写出优秀的并发代码。</p><p>这章就是介绍如何设计你的并发代码、在写并发代码的时候需要考虑的一些因素和注意的地方。从一个更高的角度去思考如何写并发代码。</p><h2><span id="如何给线程分配工作">如何给线程分配工作</span></h2><p>当我们起多个线程去做并行计算的时候我们需要把原来一个线程处理的数据分配给不同的线程。那么如何切分数据就有很多种选择：</p><p><strong>简单粗暴的根据数量切分</strong></p><p>比如有100个数据，我们起了m个线程那么每个线程处理100/m个数据。如果有必要的话最后将处理的结果进行合并。打个比方，我们现在要洗n个碗，那么我们可以把线程想象成洗碗工，如何给洗碗工分配工作，假设每个洗碗工洗碗速度差不多，那么只需要把盘子分成若干份分配给各个洗碗工即可。（当然你要有足够多的洗碗池）</p><p><img src="/img/cpp_concurrency_in_action_f_81.png" alt="Alt text"></p><p><strong>递归的切分</strong></p><p>有很多算法无法在一开始就很好的对数据进行切分，那么我们就可以用递归的方法。但是递归的话就不能暴力的去起线程，而是可以用<code>std::async</code>让线程库去决定是否在另外线程执行。</p><p><img src="/img/cpp_concurrency_in_action_f_82.png" alt="Alt text"></p><p><strong>按照任务类型进行切分</strong></p><p>还是用厨房打比方，如果现在收到了一个订单需要做100份宫保鸡丁。如果按照第一种方法的话就是把100道分给n个厨师，每个厨师负责做100/n份。那么这个有什么问题呢？每个厨师都需要去洗菜、切菜、炒菜、装盘等。每一道工具之间会浪费厨师的时间，而且如果厨房不是足够大的话，厨师之间可能会出现竞争关系，比如说只有3个炒锅、那么有一些厨师可能需要排队才能用到炒锅。</p><p>现实中的厨房肯定不是这样的，每一个环节都是有专门的人负责的。洗菜工、打荷、厨师。这样流水线的工作可以提高效率。</p><p>按照任务类型的切分方法跟厨房的这个思想是一样的，每个线程都有自己的指责，接受输入处理相对独立的功能。</p><h2><span id="影响并发代码性能的因素">影响并发代码性能的因素</span></h2><p>在说影响性能的因素之前，先来看一张表<a href="https://gist.github.com/jboner/2841832" target="_blank" rel="external">Latency Numbers Every Programmer Should Know</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line">Latency Comparison Numbers</span><br><span class="line">--------------------------</span><br><span class="line">L1 cache reference                           0.5 ns</span><br><span class="line">Branch mispredict                            5   ns</span><br><span class="line">L2 cache reference                           7   ns                      14x L1 cache</span><br><span class="line">Mutex lock/unlock                           25   ns</span><br><span class="line">Main memory reference                      100   ns                      20x L2 cache, 200x L1 cache</span><br><span class="line">Compress 1K bytes with Zippy             3,000   ns        3 us</span><br><span class="line">Send 1K bytes over 1 Gbps network       10,000   ns       10 us</span><br><span class="line">Read 4K randomly from SSD*             150,000   ns      150 us          ~1GB/sec SSD</span><br><span class="line">Read 1 MB sequentially from memory     250,000   ns      250 us</span><br><span class="line">Round trip within same datacenter      500,000   ns      500 us</span><br><span class="line">Read 1 MB sequentially from SSD*     1,000,000   ns    1,000 us    1 ms  ~1GB/sec SSD, 4X memory</span><br><span class="line">Disk seek                           10,000,000   ns   10,000 us   10 ms  20x datacenter roundtrip</span><br><span class="line">Read 1 MB sequentially from disk    20,000,000   ns   20,000 us   20 ms  80x memory, 20X SSD</span><br><span class="line">Send packet CA-&gt;Netherlands-&gt;CA    150,000,000   ns  150,000 us  150 ms</span><br></pre></td></tr></table></figure><p>计算机的计算发生在CPU，而数据则来自内存、磁盘甚至网络上。从上表可以看到，CPU访问的数据来源对于它的访问速度差距巨大。从最快的L1缓存到网络访问，差距有3亿倍之巨。</p><p>下面要说的几点，基本上可以理解为需要经常从“很远的”读取数据。</p><p><strong>线程数量</strong></p><p>线程数量并非越多越好，当线程的数量太多，而且都有实际运算需要进行的时候。操作系统会进行调度来保证线程之间的公平，而切换线程的时候会出现上下文切换。也就是说要把当前线程相关的上下文存下来，然后把另一个线程的上下文载入，这回带来一定的开销。当线程数量增加的时候，带来的开销也就越来越大。</p><p><strong>Data Contention（数据竞争）</strong></p><p>可以理解为多个线程同时去操作一个内存，至少有一个去写这块内存。如果所有的操作都是只读的话就没有问题，因为数据从内存载入CPU以后会一直有效。但是，当其他核/CPU去操作这块内存的时候，载入的数据就会失效，当前的核就需要重新去内存中载入这块内存。</p><p>如果有多个核同时在操作某一个内存的时候，这将会是灾难性的。因为每一次写，其他所有用到这个数据的核都需要重新载入这块内存。而多个核频繁写的话，就会让用到数据的和核频繁去载入内存。而我们知道从内存读数据是很慢的。这个现象可以很形象的称为cache-pingpong。</p><p><strong>False Sharing</strong></p><p>CPU载入内存的时候是按照一个内存块载入的，而不是具体单个内存地址，这块内存又称为cache-line。这个机制会带来什么问题呢？如果我们需要的是一个小块数据，但是cache-line在如何很多我们不需要的数据。我们不需要不要紧，麻烦的是这些数据可能被其他线程用到而且需要修改，当他们改了这块内存以后我们就莫名的躺枪了。因为我们载入的这块cache-line失效了。</p><p><strong>Data Proximity</strong></p><p>如果你需要处理的数据不再同一个cache-line里面也会带来问题，就是你需要载入很多内存块去用到你的数据。</p><h2><span id="设计数据结构的时候需要注意什么">设计数据结构的时候需要注意什么</span></h2><p>针对上面这几个可能会影响性能的地方，我们再设计数据结构的时候需要注意一下几点：</p><ol><li>给不同线程分配数据的时候要考虑他们之间的数据不要靠的太近避免false sharing。</li><li>单个线程需要的数据尽量挨得近一点，从而不用去载入太多cache-line。</li><li>尽量减少线程对于数据的需求。</li></ol><h2><span id="设计多线程代码其他注意事项">设计多线程代码其他注意事项</span></h2><p><strong>异常安全</strong></p><p>如果你起的线程有未处理的异常，程序将会退出(C++调用<code>std::terminate</code>)。当然你可以在线程代码内部处理掉异常，但是你需要将这个异常告诉外部从而外部能够知道错误状态来进行一些善后。</p><p>C++11里面可以用<code>std::future</code>的方式自然地实现这个，因为在<code>std::future::get</code>的时候如果线程有未处理的异常，会在调用的地方重新抛出来。</p><p><strong>可扩展性</strong></p><p>可扩展性的意思是当处理器数量增加的时候，程序能够在更短的时间内完成任务或者在相同时间内能够处理更多的数据。</p><p>一个程序内部可以分为两部分，一部分为串行部分，而另一部分则是可以被并行的部分。有一个Amdahl定律简单地描述了并发代码的性能，给出的公式如下：</p><p>$$    P = \dfrac{1}{f_s+\frac{1-f_s}{N}} $$</p><p>P为整体性能，$f_s$表示程序中串行的部分，N为处理器的数量。所以当试图优化代码的时候最好权衡一下优化能够带来的效益。应该让代码尽量的能够并行，这样能够充分利用好处理器增加带来的好处。另外如果串行的部分比例很大，比如说80%，那么优先去优化串行部分显然是比较划算的。</p><p><strong>提高响应速度</strong></p><p>在GUI应用中尽量将一些好使的操作放在非UI线程去做，这样子能够提高UI的响应速度从而提高用户体验。</p>]]></content>
    
    <summary type="html">


        &lt;p&gt;这本书前面几章介绍了C++并发编程中使用到的一些具体工具，掌握了这些具体工具并不能够保证你能够写出优秀的并发代码。&lt;/p&gt;
&lt;p&gt;这章就是介绍如何设计你的并发代码、在写并发代码的时候需要考虑的一些因素和注意的地方。从一个更高的角度去思考如何写并发代码。&lt;/p&gt;
&lt;h2&gt;&lt;s
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="C++11" scheme="http://zhengyi.me/tags/C-11/"/>
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="并发编程" scheme="http://zhengyi.me/tags/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
  </entry>
  
  <entry>
    <title>《C++ Concurrency In Action》读书笔记 - C++内存模型</title>
    <link href="http://zhengyi.me/2018/04/25/cpp-concurrency-in-action-reading-notes-cpp-memory-model/"/>
    <id>http://zhengyi.me/2018/04/25/cpp-concurrency-in-action-reading-notes-cpp-memory-model/</id>
    <published>2018-04-25T13:21:00.000Z</published>
    <updated>2018-05-22T13:58:55.265Z</updated>
    
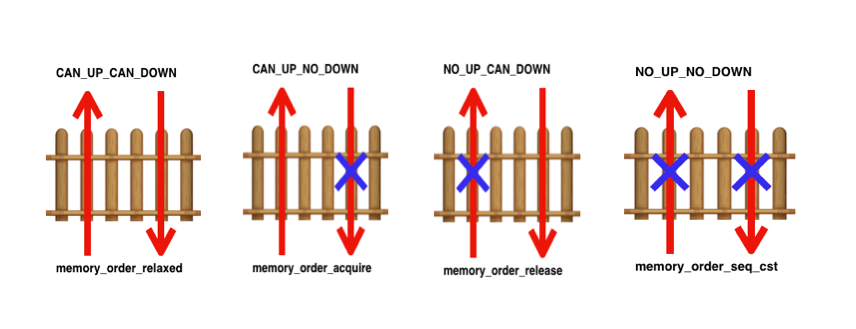
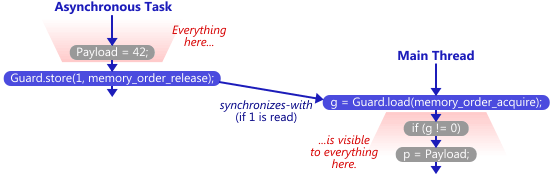
    <content type="html"><![CDATA[<p>本书第五章讲的是C++内存模型和原子操作。如果没有了解过内存模型，可能会在读这一章的时候云里雾里，不知道内存模型到底是干什么的。可以先通过这篇文章科普一下<a href="/2018/04/17/what-is-memory-model/" title="什么是内存模型">什么是内存模型</a>)。简单的理解C++内存模型就是，C++规定的跟程序员之间的一个协议，协议内容主要是保证在data race的情况下程序的行为是什么样的。</p><h2><span id="c内存模型">C++内存模型</span></h2><p>在谈具体的C++内存模型之前，需要先了解一下什么是重排(reordering)，以及重排会给我们带来什么样的问题。</p><p>重排主要存在于两个阶段，一个阶段是编译时，当C++代码编译成指令的时候编译器会在不影响程序的前提下对程序进行重排和优化。另一个是运行时，处理器会在对结果没有影响的情况下对指令进行重排。两个重排的目的都是为了提升性能。这两个重拍的前提都是它们认为对结果不会产生影响，这个推导在单线程的情况下是成立的。但是当这段代码涉及到多线程，情况可能就会不如你所愿。举个很简单的例子， <code>y==42</code>乍看之下不可能为false，但是这个是不能够100%保证的。为什么？因为重排。而重排按照以下这种写法是无法控制的。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">int x = 0;</span><br><span class="line">int y = 0;</span><br><span class="line">// run at thread 1</span><br><span class="line">void M1() &#123;</span><br><span class="line">    y = 42;           // 1</span><br><span class="line">    x = 1;            // 2</span><br><span class="line">&#125;</span><br><span class="line">// run at thread 2</span><br><span class="line">void M2() &#123;</span><br><span class="line">    while (x!=1);     // 1</span><br><span class="line">    assert(y+x==42);    // 2</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这也就是内存模型所要解决最大的问题：对抗重排。更加具体一点，C++内存模型主要要解决的问题是：</p><ul><li>对抗重排，让程序能够按照我们想要的顺序去执行，能够在任何情况下都保证结果正确，而是不靠运气；</li><li>上面代码除了重排以外还存在的问题就是，在访问同一块内存的时候没有加保护，而这个是会导致未定义的行为的，内存模型需要解决data race的情况下给出一套可预期的行为。</li></ul><h3><span id="通俗版本">通俗版本</span></h3><p>那么对抗重排不可能说让整个程序都不允许任何重排，这个是不可能的。准确的讲，我们其实是不想看到会影响我们预期效果的重排。拿上面那个程序举个例子，上面的M1和M2之间其实存在着某种依赖关系。当M2.1中<code>x!=1</code>不成立的时候，我们期望看到的是M1.1已经完成执行了，我们可以理解成M2.2依赖于M1.1的操作。</p><p>那么对抗重排的武器是什么，是fence，又叫memory barrier。我们可以在M1.2处设置一个边界，清楚地告诉编译器和处理器你们在这个边界上面乱搞可以，但是请不要跑到下面来。然后在M2.1处也设置一个边界，告诉编译器和处理器你们在这行下面乱搞可以，但是请不要跑到上面来。</p><p>既然是边界，那么就有两个方向，根据不同的规则可以定义以下四种边界：CAN_UP_CAN_DOWN(能上能下)，CAN_UP_NO_DOWN(能上不能下)，NO_UP_NO_DOWN(不能上不能下)，NO_UP_CAN_DOWN(不能上能下)。</p><p>那么我们改写一下上面的代码</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">// run at thread 1</span><br><span class="line">void M1() &#123;</span><br><span class="line">    y = 42;           // 1</span><br><span class="line">    CAN_UP_NO_DOWN</span><br><span class="line">    x = 1;            // 2</span><br><span class="line">&#125;</span><br><span class="line">// run at thread 2</span><br><span class="line">void M2() &#123;</span><br><span class="line">    while (x!=1);     // 1</span><br><span class="line">    NO_UP_CAN_DOWN</span><br><span class="line">    assert(y+x==43);    // 2</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>那么对应到C++中的内存模型的话可以用下面这幅图来理解</p><p><img src="/img/explain_memory_order_using_fence.png" alt="explain_memory_order_using_fence"></p><p>用这种通俗的理解方法，这四种内存模型(<em>memory_order_relaxed</em>, <em>memory_order_acquire</em>, <em>memory_order_release</em>,  <em>memory_order_seq_cst</em>)应该就不难理解了。还有一种比较特殊的是<em>memory_order_consume</em>，这个是上面第四个的一个弱化版。还是拿我们这个程序来举例，我们这个例子中M2.2其实只依赖于M1.1这一行，而不依赖于其他行的代码。所以我们只需要保证M1.1在CAN_UP_NO_DOWN以上，M2.2在NO_UP_CAN_DOWN以下就能够保证正确性了，没有必要一竿子把所有的操作都限制住。可以让更多的表达式通过fence，自由自在的优化。</p><h3><span id="专业版本">专业版本</span></h3><p>上面用我自己理解的通俗版本介绍了这几种内存模型的区别，专业版的话需要搞清楚两个概念：<em>Happens-Before</em>和 <em>Synchronizes-With</em>。推荐大家直接阅读参考资料中的两篇文章，讲得很好，以我目前的理解水平还不能够比这两篇文章更好更通俗的去解释这两个概念。读完就基本知道是怎么回事了。</p><h2><span id="c-atomic注意事项">C++ atomic注意事项</span></h2><p>使用C++中的atomic有以下一些注意事项：</p><ul><li>预定义的<code>atomic</code>类型基本都重载了常用的操作符，所以你如果用起来的话可以跟普通基础类型一样。但是默认用的memory order是最强的<code>memory_order_seq_cst</code>。所以你在理解memory oder的情况下应该尽可能的使用相对较弱的memory order。特别是如果你的代码可能跑在ARM等弱内存序的处理器上。</li><li>如果要使用一个自定义的类型扩展<code>std::atomic</code> ，那么这个类型必须满足一下两个条件：这个类型及其所有父类和非静态的成员都必须有trival copy-assignment操作符，简单地说就是能够用<code>memcpy</code>直接进行拷贝；二，必须是在字节层面能够直接比较的，可以理解为能够用<code>memcmp</code>进行比较</li></ul><h2><span id="参考">参考</span></h2><ul><li><a href="http://preshing.com/20130702/the-happens-before-relation/" target="_blank" rel="external">The Happens-Before Relation</a></li><li><a href="http://preshing.com/20130823/the-synchronizes-with-relation/" target="_blank" rel="external">The Synchronizes-With Relation</a></li><li><a href="http://preshing.com/20140709/the-purpose-of-memory_order_consume-in-cpp11/" target="_blank" rel="external">The Purpose of memory_order_consume in C++11</a></li></ul>]]></content>
    
    <summary type="html">


        &lt;p&gt;本书第五章讲的是C++内存模型和原子操作。如果没有了解过内存模型，可能会在读这一章的时候云里雾里，不知道内存模型到底是干什么的。可以先通过这篇文章科普一下&lt;a href=&quot;/2018/04/17/what-is-memory-model/&quot; title=&quot;什么是内存模型&quot;&gt;
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="C++11" scheme="http://zhengyi.me/tags/C-11/"/>
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="并发编程" scheme="http://zhengyi.me/tags/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
  </entry>
  
  <entry>
    <title>《C++ Concurrency In Action》读书笔记 - 线程间同步机制</title>
    <link href="http://zhengyi.me/2018/04/20/cpp-concurrency-in-action-reading-notes-sync-between-threads/"/>
    <id>http://zhengyi.me/2018/04/20/cpp-concurrency-in-action-reading-notes-sync-between-threads/</id>
    <published>2018-04-20T14:22:22.000Z</published>
    <updated>2018-05-22T13:58:55.266Z</updated>
    
    <content type="html"><![CDATA[<p>前面介绍了<a href="/2018/04/10/cpp-concurrency-in-action-reading-notes-sharing-data/" title="线程间如何安全的共享数据">线程间如何安全的共享数据</a>，主要是通过互斥量和锁来实现。除了共享数据以外，线程间还需要进行同步的操作，比如说有某个事件需要通知。C++11引入了两个基本的机制来实现线程间的通信：<em>condition variables</em> 和<em>futures</em>。</p><h2><span id="condition-variables">condition variables</span></h2><p>condition variables主要是用来等待某个事件的通知，比如说线程1专门负责处理数据，线程2则是从IO读取数据放到队列里。这个时候线程1就需要等队列空闲的时候等待新的数据，而线程2则需要在数据放入队列以后通知线程1。代码如下：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br></pre></td><td class="code"><pre><span class="line">// Thread 1</span><br><span class="line"></span><br><span class="line">std::mutex mtx;</span><br><span class="line">std::queue&lt;data&gt; data_queue;</span><br><span class="line">std::condition_variable cond;</span><br><span class="line"></span><br><span class="line">void process_data()</span><br><span class="line">&#123;</span><br><span class="line">while (true)</span><br><span class="line">&#123;</span><br><span class="line">std::unique_lock&lt;mtx&gt; lk;</span><br><span class="line">cond.wait(lk, []&#123;return !data_queue.empty();&#125;); // 1</span><br><span class="line">auto data = data_queue.front();</span><br><span class="line">data_queue.pop();</span><br><span class="line">lk.unlock();                                    // 2</span><br><span class="line">process(data);</span><br><span class="line">if (is_last_chunk(data))</span><br><span class="line">break;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">void prepare_data()</span><br><span class="line">&#123;</span><br><span class="line">while(more_data_to_prepare())</span><br><span class="line">&#123;</span><br><span class="line">auto data = prepare_data();</span><br><span class="line">std::unique_lock&lt;mtx&gt; lk;</span><br><span class="line">data_queue.push(data);</span><br><span class="line">cond.notify_one();                               // 3</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这段代码有几个关键的知识点：</p><ul><li>为什么#1处<code>condition_variable</code> wait的时候需要传一个<code>unique_lock</code>？</li><li>为什么#1处，需要判断<code>data_queue.empty</code>？</li><li>#1，除了<code>wait</code>以外还有没有其他方式？</li><li>为什么#2处要显式<code>unlock</code>？</li><li>#3 处是否还有其他notify的方式，并且有何区别？</li></ul><p><strong>为什么#1处<code>condition_variable</code> wait的时候需要传一个<code>unique_lock</code>？</strong></p><p>第一次看到<code>condition_variable</code>会比较奇怪为什么需要传入一个锁。这个是因为，<code>condition_variable</code>需要运行pred来检查是否满足等待条件，而这个往往是需要访问共享数据的，这个锁是用来保护这段共享数据的。</p><p>这个是其中一个原因，但是你会发现有一个<code>wait</code>函数是不需要传入predicate的。这个时候这个lock的意义则在于保护<code>condition_variable</code>本身内部的信号。因为多个线程会同时访问这个<code>condition_variable</code>，所以需要某种机制来对其内部的数据结构进行保护。<sup>[1]</sup></p><p><strong>为什么#1处，需要判断<code>data_queue.empty</code>？</strong></p><p>有一种wake up叫做<em>spurious wakeup</em>。简单地说就是，被notify了但是其实有可能它需要等待的那个条件已经不满足了，在这个例子中就是data_queue可能在它被唤醒的时候是empty。那么为什么会出现这种情况呢？</p><p>我们可以想一下<code>condition_variable</code>内部是怎么实现的，下面这段伪代码</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">void</span><br><span class="line">condition_variable::wait(unique_lock&lt;mutex&gt; &amp;lock)</span><br><span class="line">&#123;</span><br><span class="line">lock.unlock();</span><br><span class="line">// some system call to wait for event</span><br><span class="line">lock.lock();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>可以看到，<code>wait</code>的开始的时候应该会先把把mutex给释放掉，然后等待系统事件。当收到事件以后则会再次尝试去获取mutex。可以看到在收到系统事件和获取mutex这期间是没有任何mutex做为保护的。在这个时候很有可能外部的条件已经被另外的线程给修改掉了，所以之后再次获取到mutex并不能保证一定满足所需要等待的条件。</p><p>看了一下<em>libcxx</em>内部的实现，它其实是直接调用了pthread的<code>pthread_cond_wait</code>。而在<code>pthread_cond_wait</code>的内部实现则不是我上面说的那么简单，还有很多其他的操作。这个具体代码我也没有完全看明白，就不在这里详述，有机会另外再研究。（我看的是glibc里面pthread的实现）。</p><p><strong>除了<code>wait</code>以外还有没有其他方式？</strong></p><p>除了<code>wait</code>以外还提供了<code>wait_until</code>和<code>wait_for</code>两个api，主要是用来避免等待太久。内部实现的话<code>wait_until</code>其实是转换成了<code>wait_for</code>，所以一个比较有意思的事情是如果你在等待期间去修改系统的时间的话，对于最终等待的时间是不会产生影响的，它内部开始的时候已经换算成时间差了。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line">std::condition_variable cv;</span><br><span class="line">std::mutex mtx;</span><br><span class="line">std::unique_lock&lt;std::mutex&gt; lk(mtx);</span><br><span class="line">auto now = std::chrono::system_clock::now();</span><br><span class="line">std::time_t now_c = std::chrono::system_clock::to_time_t(now);</span><br><span class="line">std::cout &lt;&lt; std::put_time(std::localtime(&amp;now_c), &quot;%T&quot;) &lt;&lt; std::endl;</span><br><span class="line">cv.wait_until(lk, now + std::chrono::seconds(10));</span><br><span class="line">now = std::chrono::system_clock::now();</span><br><span class="line">now_c = std::chrono::system_clock::to_time_t(now);</span><br><span class="line">std::cout &lt;&lt; std::put_time(std::localtime(&amp;now_c), &quot;%T&quot;) &lt;&lt; std::endl;</span><br><span class="line"></span><br><span class="line">// output:</span><br><span class="line">20:57:19</span><br><span class="line">20:52:27</span><br></pre></td></tr></table></figure><p><strong>为什么#2处要显式<code>unlock</code>？</strong></p><p>拿到数据以后，data_queue已经不需要保护，而且处理数据可能会比较耗时。没有必要在这个地方去一直拿着mutex。</p><p><strong>#3 处是否还有其他<code>notify</code>的方式，并且有何区别？</strong></p><p>可以选择<code>notify_one</code>和<code>notify_all</code>，顾名思义。两个的区别是唤醒的等待线程数量不一样。notify方法调用的时候是需要去获取mutex的。</p><h2><span id="stdfuture">std::future</span></h2><p>一个异步方法如何返回一个结果，C/C++程序员的第一反应应该是用回调函数。回调函数确实可以解决这个问题，但是回调函数本身也有着诸多的问题。C++11中引入lambda和闭包，能够让这个问题有所缓解。但是使用回调的方法并非一个优雅的解决方法。</p><p>举个例子</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line">void CalcSomething()</span><br><span class="line">&#123;</span><br><span class="line">    std::mutex mtx;</span><br><span class="line">    std::condition_variable cv;</span><br><span class="line">    </span><br><span class="line">    int result = 0;</span><br><span class="line">    doSomethingAsync(11, [&amp;result, &amp;cv](int r)&#123;</span><br><span class="line">        result = r;</span><br><span class="line">        cv.notify_one();</span><br><span class="line">    &#125;);</span><br><span class="line">    // Do other things</span><br><span class="line">    std::unique_lock&lt;std::mutex&gt; lk(mtx);</span><br><span class="line">    cv.wait(lk);</span><br><span class="line">    // use result to do more calculation</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>看着就蛋疼。那么future就是可以帮我们解决这个问题。有了它我们可以这么写代码。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">void CalcSomething()</span><br><span class="line">&#123;</span><br><span class="line">    auto f = doSomethingAsync(11);</span><br><span class="line">    // Do other things</span><br><span class="line">    f.wait();</span><br><span class="line">    int result = f.get();</span><br><span class="line">    // use result to do more calculation</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>确实可以大大简化我们原来的代码，其实隐约看到另外一种编程的方法。但是在很多时候还是不够用，比如说CalcSomething也是一个异步方法，我想让结果等待以后继续做事情但不想同步的等。那么我们可以起一个线程去执行上述代码，比如</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line">void CalcSomethingUseThread()</span><br><span class="line">&#123;</span><br><span class="line">    std::thread t([]&#123;</span><br><span class="line">        auto f = doSomethingAsync(11);</span><br><span class="line">        // Do other things</span><br><span class="line">        f.wait();</span><br><span class="line">        int result = f.get();</span><br><span class="line">        // use result to do more calculation</span><br><span class="line">        &#125;);</span><br><span class="line">    t.detach();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>但是很显然随随便便起一个线程只为做这么简单的事情未免开销太大了，而且很多项目里是有类似线程池来统一管理线程的。目前的future还不能够很好地处理这种需求，要么用独立线程运行，要么通过注册回调来做。</p><p>不过<code>Folly::Future</code>对<code>std::future</code>做了极大的扩充，提供了类似的解决方案。有兴趣的可以去了解一下。</p><p>实际运用中C++11中的<code>std::future</code>有点鸡肋的感觉，除非在C++20以后能够加入更加多的功能，否则并没有很大的吸引力去用这套机制。</p><h2><span id="参考">参考</span></h2><ol><li><a href="https://stackoverflow.com/questions/2763714/why-do-pthreads-condition-variable-functions-require-a-mutex" target="_blank" rel="external">Stackoverflow - Why do pthreads’ condition variable functions require a mutex?</a></li><li><a href="https://stackoverflow.com/questions/1461913/does-c-sharp-monitor-wait-suffer-from-spurious-wakeups/1461956#1461956" target="_blank" rel="external">Jon Skeet - Does C# Monitor.Wait() suffer from spurious wakeups?</a></li></ol>]]></content>
    
    <summary type="html">


        &lt;p&gt;前面介绍了&lt;a href=&quot;/2018/04/10/cpp-concurrency-in-action-reading-notes-sharing-data/&quot; title=&quot;线程间如何安全的共享数据&quot;&gt;线程间如何安全的共享数据&lt;/a&gt;，主要是通过互斥量和锁来实现。除了共享
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="C++11" scheme="http://zhengyi.me/tags/C-11/"/>
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="并发编程" scheme="http://zhengyi.me/tags/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
  </entry>
  
  <entry>
    <title>什么是内存模型（Memory Consistency Model）</title>
    <link href="http://zhengyi.me/2018/04/17/what-is-memory-model/"/>
    <id>http://zhengyi.me/2018/04/17/what-is-memory-model/</id>
    <published>2018-04-17T12:59:46.000Z</published>
    <updated>2018-05-22T13:58:55.267Z</updated>
    
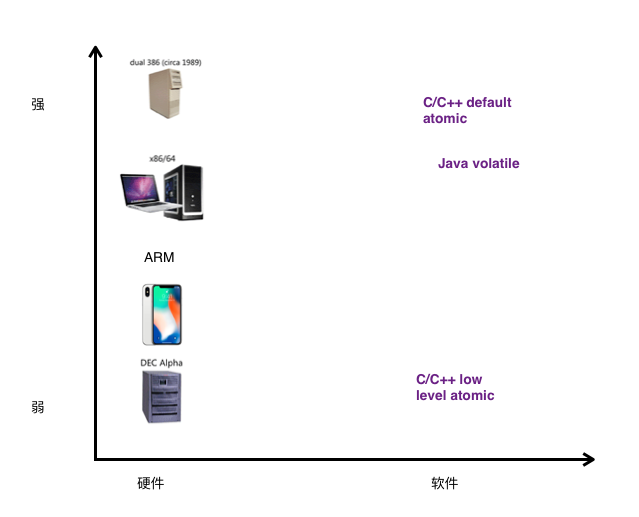
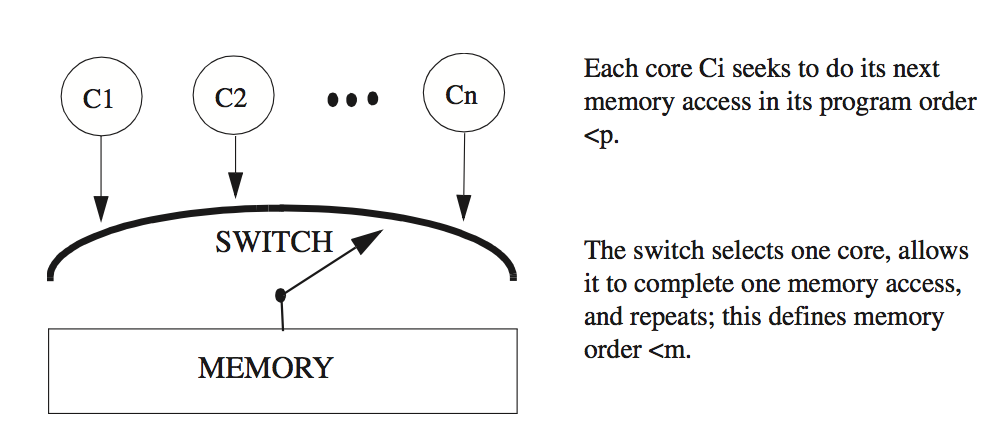
    <content type="html"><![CDATA[<p>最近在看 <em>《C++ Concurrency in Action》</em>第五章C++内存模型的时候，对于其中提到的一些知识点有点理解困难。所以另外找了一些资料先了解一些什么是内存模型，先对与内存模型有一个整体的概念然后再深入去了解C++的内存模型。</p><h2><span id="什么是内存模型">什么是内存模型</span></h2><blockquote><p>In computing, a memory model describes the interactions of threads through memory and their shared use of the data.<br><em>Wikipedia</em></p></blockquote><p>有点抽象，似乎还是没有很好地定义出内存模型是什么，下面这段是摘自<em>A Primer on Memory Consistency and Cache Coherence</em>(<em>APMCCC</em>)<sup>1</sup>第三章。</p><blockquote><p>A memory consistency model, or, more simply, a memory model, is a specification of the allowed behavior of multithreaded programs executing with shared memory. For a multithreaded program executing with specific input data, it specifies what values dynamic loads may return and what the final state of memory is.</p></blockquote><p>简单的说，内存模型可以理解为一套协议，定义多个处理器/线程在在操作内存的时候需要遵循的一套协议。什么是允许的什么是不允许的。</p><p>可以看到这里的内存模型和内存一致性模型指的是同一个概念。</p><p>内存一致性模型的很多概念可以推广到一致性模型，一致性模型则是在分布式系统中很重要的一个概念。从某一个角度来说，多(核)处理器与内存的关系也是一种分布式系统。</p><h2><span id="内存模型的分类">内存模型的分类</span></h2><p>内存模型可以分为硬件内存模型(hardware memory model)和软件内存模型(software memory model) <sup>3</sup>。</p><p>硬件内存模型可以理解为硬件与软件之间的一套协议(contract between the hardware and software) <sup>2</sup>，硬件会在协议中说明会在什么情况下进行重排什么情况下不会。这里的硬件一般指的是处理器，而软件指的是操作处理器的指令。</p><p>软件内存模型可以理解为程序员和编程语言之间的一套协议(contract between programmer and programming language)，编程语言会规定一套规则来说明什么情况下会对代码进行重排，并且提供一些机制能够让程序员对一些操作进行控制。</p><p>从硬件和软件的角度是看内存模型的一个维度，另一个维度则是一致性的强度。一致性可以是强一致性也可以是弱一致性。</p><p><img src="/img/what-is-memory-model/category.png" alt="Category"></p><p>这张不严谨的图参考自<a href="http://preshing.com/20120930/weak-vs-strong-memory-models/" target="_blank" rel="external">Weak vs. Strong Memory Models</a>，稍微做了一下变换。</p><p>大部分程序员关心的是软件维度的内存模型，即程序员和编程语言之间的协议。内存模型的强度与软硬件无管，是抽象层面的一个东西即适用于硬件也适用于软件。</p><p>在<a href="https://en.wikipedia.org/wiki/Consistency_model" target="_blank" rel="external">wikipedia</a>上我们可以看到有很多不同的一致性模型分类，这里对于C++中的内存模型比较相关的是：Sequential Consistency、Release consistency。</p><h3><span id="sequential-consistency">Sequential Consistency</span></h3><p>Sequential Consistency(SC)是最符合直觉的一种内存模型也是很关键的一种。是由Leslie Lamport在<a href="https://www.microsoft.com/en-us/research/publication/make-multiprocessor-computer-correctly-executes-multiprocess-programs/?from=http%3A%2F%2Fresearch.microsoft.com%2Fen-us%2Fum%2Fpeople%2Flamport%2Fpubs%2Fmulti.pdf" target="_blank" rel="external">1979年提出来的</a>。</p><p>理解这个模型有两个关键点：</p><ol><li>程序的执行顺序按照代码顺序</li><li>代码中对于内存的访问不会被乱序</li></ol><p>#1 很好理解，即执行顺序不会随意重排，尊重代码顺序。#2则不是很好实现，</p><p><img src="/img/what-is-memory-model/switch.png" alt="Memory access as switch"></p><p>上图为<em>APMCCC</em>中的截图。把内存操作想象成都需要通过一个开关，每次内存都挑选一个核允许其进行内存访问。这样就可以保证所有的内存访问不会被乱序。不难发现这个模型最大的问题就是同一时间只能有一个核对内存进行访问，这个很大程度上削弱了多核带来的提升。</p><h3><span id="release-consistency">Release consistency</span></h3><p>在Release consistency中进入critical section(关键区)称为acquire，离开critical section称为release。Acquire操作是读操作，release是写操作。</p><p>简单的理解就是acquire操作会阻止所有在此操作以下的内存读取操作被重排到此操作前。release会保证所有操作之前的内存读取操作不会被重排到release操作后。下图可以很清晰的表达这个关系(<a href="http://preshing.com/20140709/the-purpose-of-memory_order_consume-in-cpp11/" target="_blank" rel="external">The Purpose of memory_order_consume in C++11</a>)：</p><p><img src="/img/what-is-memory-model/release_consistency.png" alt="Release Consistency"></p><h2><span id="总结">总结</span></h2><p>对于理解C++的内存模型，上面的这些预备知识就差不多足够了。强烈推荐阅读Preshing关于Lock-free的一系列博客，还有这本小书<em>A Primer on Memory Consistency and Cache Coherence</em>。</p><p>Preshing的Lock-free的系列博客，没有列全，可以顺藤摸瓜找到相关文章。</p><ul><li><a href="http://preshing.com/20120710/memory-barriers-are-like-source-control-operations/" target="_blank" rel="external">Memory Barriers Are Like Source Control Operations</a></li><li><a href="http://preshing.com/20120930/weak-vs-strong-memory-models/" target="_blank" rel="external">Weak vs. Strong Memory Models</a></li><li><a href="http://preshing.com/20120913/acquire-and-release-semantics/" target="_blank" rel="external">Acquire and Release Semantics</a></li><li><a href="http://preshing.com/20140709/the-purpose-of-memory_order_consume-in-cpp11/" target="_blank" rel="external">The Purpose of memory_order_consume in C++11</a></li></ul><h2><span id="参考">参考</span></h2><ol><li><a href="https://www.morganclaypool.com/doi/abs/10.2200/S00346ED1V01Y201104CAC016" target="_blank" rel="external"><em>A Primer on Memory Consistency and Cache Coherence</em>, Daniel J. Sorin, Mark D. Hill, David A. Wood</a></li><li><a href="https://homes.cs.washington.edu/~bornholt/post/memory-models.html" target="_blank" rel="external"><em>Memory Consistency Models: A Primer</em>, James Bornholt</a></li><li><a href="http://preshing.com/20120930/weak-vs-strong-memory-models/" target="_blank" rel="external"><em>Weak vs. Strong Memory Models</em>, Jeff Preshing</a></li><li><a href="http://preshing.com/20120913/acquire-and-release-semantics/" target="_blank" rel="external">Acquire and Release Semantics</a></li><li><a href="https://herbsutter.com/2012/08/02/strong-and-weak-hardware-memory-models/" target="_blank" rel="external">“Strong” and “weak” hardware memory models</a></li></ol>]]></content>
    
    <summary type="html">


        &lt;p&gt;最近在看 &lt;em&gt;《C++ Concurrency in Action》&lt;/em&gt;第五章C++内存模型的时候，对于其中提到的一些知识点有点理解困难。所以另外找了一些资料先了解一些什么是内存模型，先对与内存模型有一个整体的概念然后再深入去了解C++的内存模型。&lt;/p&gt;
&lt;h2
      
    
    </summary>
    
      <category term="并发编程" scheme="http://zhengyi.me/categories/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
    
      <category term="并发编程" scheme="http://zhengyi.me/tags/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
      <category term="系统架构" scheme="http://zhengyi.me/tags/%E7%B3%BB%E7%BB%9F%E6%9E%B6%E6%9E%84/"/>
    
  </entry>
  
  <entry>
    <title>层级锁 - Lock Hierarchies</title>
    <link href="http://zhengyi.me/2018/04/11/what-is-lock-hierarchy/"/>
    <id>http://zhengyi.me/2018/04/11/what-is-lock-hierarchy/</id>
    <published>2018-04-11T14:43:02.000Z</published>
    <updated>2018-05-22T13:58:55.267Z</updated>
    
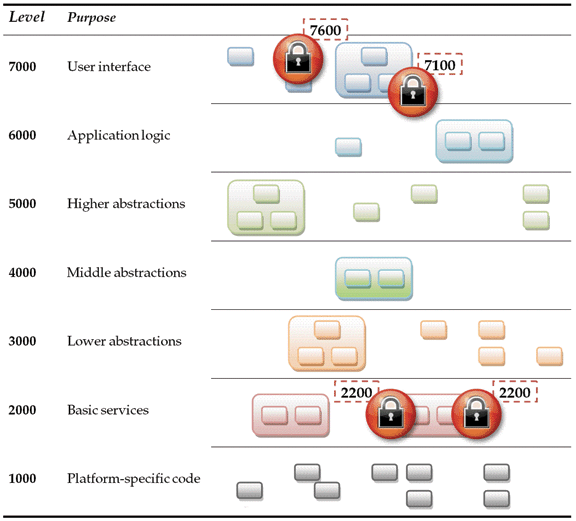
    <content type="html"><![CDATA[<p>《C++ Concurrency in Action》(CCIA)第三章中提到一个Lock Hierarchy的办法能够有效地避免死锁。这里结合Herb Sutter的这篇文章<a href="http://collaboration.cmc.ec.gc.ca/science/rpn/biblio/ddj/Website/articles/DDJ/2008/0801/071201hs01/071201hs01.html" target="_blank" rel="external">Use Lock Hierarchies to Avoid Deadlock</a>简单得了解一下这个Lock Hierarchy。</p><p>一个典型的死锁会发生在如下的场景中：</p><ul><li>一段代码试图去同时独占地去获取两个共享资源（mutex或者其他）a和b，按照先a后b的顺序。</li><li>另一段代码试图去同时独占的去获取两个共享资源a和b，但是获取顺序是相反，先b后a。</li><li>这两段代码可能同时执行。</li></ul><p>这种情况下就会出现个两个代码块互相等待对方资源的情况，造成死锁。并非所有的情况都是很明确的能看到两个获取两个资源，有可能是你占有一个资源的时候调用了其他方法，也有可能是因为一些回调函数。所以这个问题可能会隐藏的很深。</p><p>普遍的建议就是永远按照同样的顺序去获取多个锁，但是正如上面所说的有时候多个锁可能是在不同的地方获取的，并没有那么明显。</p><p>有一个方法可以破这个就是Lock Hierarchies。每一个mutex都分配一个层级号码，并且严格按照下面两个规则：</p><ol><li>当占有层级为N的mutex的时候，只能去获取层次&lt; N的mutex</li><li>当试图同时占有多个同层级的mutex的时候，这些锁必须一次性获取，通过类似于<code>std::lock</code>的方法去保证顺序。</li></ol><p>Herb给了一张很形象的图来描述这个方案。</p><p><img src="/img/layer-lock.gif" alt="Layer lock"></p><p><strong>实现细节</strong></p><p>实现一个hierarchical mutex也很简单，原理和细节如下：</p><ul><li>提供一个mutex wrapper，并且在所有的地方都是用这个wrapper来进行对mutex的操作，并且能够设置一个层次号</li><li>在wrapper内部放一个thread local的变量currentLevel来保存当前线程的层次号并将其初始化为大于所有level的号码</li><li>提供一些方法，比如<code>lock</code>, <code>unlock</code>，<code>try_lock</code></li><li><code>lock</code>方法只有当currentLevel大于mutex wrapper的层次号才去上锁，否则抛出异常。如果上锁，则保存currentLevel并将currentLevel设置为当前的mutex 的层次号</li><li><code>unlock</code>的时候讲currentLevel重置会原来的层次号</li></ul><p><strong>代码</strong></p><p><em>CCIA</em>书中给出了一个很简单的<code>hierarchical_mutex</code>的实现。大家可以自己看看</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br></pre></td><td class="code"><pre><span class="line">#include &lt;mutex&gt;</span><br><span class="line">#include &lt;stdexcept&gt;</span><br><span class="line">#include &lt;climits&gt;</span><br><span class="line"></span><br><span class="line">class hierarchical_mutex</span><br><span class="line">&#123;</span><br><span class="line">    std::mutex internal_mutex;</span><br><span class="line">    unsigned long const hierarchy_value;</span><br><span class="line">    unsigned long previous_hierarchy_value;</span><br><span class="line">    static thread_local unsigned long this_thread_hierarchy_value;</span><br><span class="line"></span><br><span class="line">    void check_for_hierarchy_violation()</span><br><span class="line">    &#123;</span><br><span class="line">        if(this_thread_hierarchy_value &lt;= hierarchy_value)</span><br><span class="line">        &#123;</span><br><span class="line">            throw std::logic_error(&quot;mutex hierarchy violated&quot;);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">    void update_hierarchy_value()</span><br><span class="line">    &#123;</span><br><span class="line">        previous_hierarchy_value=this_thread_hierarchy_value;</span><br><span class="line">        this_thread_hierarchy_value=hierarchy_value;</span><br><span class="line">    &#125;</span><br><span class="line">public:</span><br><span class="line">    explicit hierarchical_mutex(unsigned long value):</span><br><span class="line">        hierarchy_value(value),</span><br><span class="line">        previous_hierarchy_value(0)</span><br><span class="line">    &#123;&#125;</span><br><span class="line">    hierarchical_mutex(const hierarchical_mutex&amp;) = delete;</span><br><span class="line">    hierarchical_mutex&amp; operator=(const hierarchical_mutex&amp;) = delete;</span><br><span class="line">    void lock()</span><br><span class="line">    &#123;</span><br><span class="line">        check_for_hierarchy_violation();</span><br><span class="line">        internal_mutex.lock();</span><br><span class="line">        update_hierarchy_value();</span><br><span class="line">    &#125;</span><br><span class="line">    void unlock()</span><br><span class="line">    &#123;</span><br><span class="line">        this_thread_hierarchy_value=previous_hierarchy_value;</span><br><span class="line">        internal_mutex.unlock();</span><br><span class="line">    &#125;</span><br><span class="line">    bool try_lock()</span><br><span class="line">    &#123;</span><br><span class="line">        check_for_hierarchy_violation();</span><br><span class="line">        if(!internal_mutex.try_lock())</span><br><span class="line">            return false;</span><br><span class="line">        update_hierarchy_value();</span><br><span class="line">        return true;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;;</span><br><span class="line">thread_local unsigned long</span><br><span class="line">    hierarchical_mutex::this_thread_hierarchy_value(ULONG_MAX);       </span><br><span class="line"></span><br><span class="line">int main()</span><br><span class="line">&#123;</span><br><span class="line">    hierarchical_mutex m1(42);</span><br><span class="line">    hierarchical_mutex m2(2000);</span><br><span class="line">    </span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">


        &lt;p&gt;《C++ Concurrency in Action》(CCIA)第三章中提到一个Lock Hierarchy的办法能够有效地避免死锁。这里结合Herb Sutter的这篇文章&lt;a href=&quot;http://collaboration.cmc.ec.gc.ca/scienc
      
    
    </summary>
    
      <category term="并发编程" scheme="http://zhengyi.me/categories/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
    
      <category term="C++11" scheme="http://zhengyi.me/tags/C-11/"/>
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="并发编程" scheme="http://zhengyi.me/tags/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
  </entry>
  
  <entry>
    <title>《C++ Concurrency In Action》读书笔记 - 线程间共享数据</title>
    <link href="http://zhengyi.me/2018/04/10/cpp-concurrency-in-action-reading-notes-sharing-data/"/>
    <id>http://zhengyi.me/2018/04/10/cpp-concurrency-in-action-reading-notes-sharing-data/</id>
    <published>2018-04-10T14:21:37.000Z</published>
    <updated>2018-05-22T13:58:55.266Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="多个线程间共享数据会出现什么问题">多个线程间共享数据会出现什么问题？</span></h2><p>如果所有的数据都是只读的，那么多线程之间同时访问是不会有问题的。但是如果有人要读的同时有人要改就会出现问题。因为并非所有操作都能在一步完成，一般的操作会是先去读取数据，然后做一些其他的运算或者判断，然后回写数据。那么可能发生以下一些情况：</p><ul><li>但是如果多个线程同时做这个操作的话，可能某一个线程回写的时候，当时判断的逻辑已经不成立了。</li><li>如果两个线程同时尝试去修改同一份数据，就会出问题。</li><li>其他更复杂的情况</li></ul><p>当多个线程共享内存并且去尝试修改内存里的内容的时候，就会出现race condition。这会让代码出现一些无法预料的情况。比如说：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">if (x == 5)</span><br><span class="line">&#123;</span><br><span class="line">y = x * 2;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这段代码在单线程下，如果x等于5，有一定等于10。但是如果多于一个线程运行这段代码，则y的值依赖于两个线程之间的执行顺序。如果还有一些线程在修改x的值，情况就更复杂了。</p><p>更糟糕的是在C++中，如果并发的修改同一个对象，会出现未定义的行为(undefined behavior)。</p><h3><span id="解决方案">解决方案</span></h3><p>应对<em>race condition</em>的解决方案有以下几种：</p><ol><li>通过某种保护机制来确保同一时间只有一个线程能够对某一个数据进行访问。</li><li>通过<em>lock-free</em>的形式进行编程。主要指的是将对于数据的修改变成一系列不可分割的操作，C++中通常利用<em>atomic</em>来实现。具体会在<em>lock-free</em>一章中进行介绍。</li><li>通过STM(software transaction memory)。这个方式是将内存的修改处理成跟数据库事务类似的机制，当修改完成commit到内存中，要么成功要么失败，不会存在中间状态。目前C++语言层面没有对这个功能的直接支持。</li></ol><p>C++中主要使用#1和#2。#1的话主要是通过<em>mutex</em>为核心来实现。</p><h2><span id="利用mutex来保护数据">利用Mutex来保护数据</span></h2><p>Mutex是<strong>mut</strong>ual <strong>ex</strong>clusion（互斥）的意思。提供了<code>lock</code>和<code>unlock</code>两个方法，<code>std::mutex</code>同一时间值能有一个线程获得lock，当有一个线程拥有<code>mutex</code>的时候，其余调用<code>lock</code>尝试获得锁的线程会处于等待状态。</p><p>mutex本质上是一种资源，所以在C++中一般使用RAII来进行封装，避免出现<code>lock</code>和<code>unlock</code>调用不配对的情况。</p><p>C++11中提供了<code>std::lock_guard&lt;class Mutex&gt;</code>和<code>std::unique_lock&lt;class Mutex&gt;</code>封装。这两个类可以接受任何符合<a href="http://en.cppreference.com/w/cpp/concept/BasicLockable" target="_blank" rel="external">BasicLockable</a>的mutex类型。</p><p>除了<code>std::mutex</code>以外，C++17中还提供了以下几种mutex：</p><ul><li><code>std::mutex</code> (since <em>C++11</em>) 同时只能有一个线程获得锁，并且一个线程之只能lock一次。</li><li><code>std::recursive_mutex</code> (since <em>C++11</em>) 可重入锁，一个线程可以多次去lock同一个recursive_mutex。</li><li><code>std::timed_mutex</code> (since <em>C++11</em>)。在<code>std::mutex</code>的基础上提供了 <code>try_lock_for</code>和<code>try_lock_until</code>，允许在超时的情况下返回。</li><li><code>std::recursive_timed_mutex</code> (since <em>C++11</em>)。在<code>std::recursive_mutex</code>的基础上提供了 <code>try_lock_for</code>和<code>try_lock_until</code>，允许在超时的情况下返回。</li><li><code>std::shared_mutex</code>  (since <em>C++17</em>)。传说中的读写锁。提供<code>lock</code>和<code>shared_lock</code>两套方法。<code>lock</code>即获得排他锁(exclusive lock)，<code>shared_lock</code>即获得共享锁(shared lock)</li></ul><h3><span id="使用mutex时候需要注意的事情">使用mutex时候需要注意的事情</span></h3><p> 当我们用mutex将我们需要保护的数据保护起来以后是不是就可以高枕无忧了呢？这只是“噩梦”的开始。。。。</p><p>你需要注意一下若干点：</p><ul><li>不要将你保护的数据当做以引用或指针形式传入“不知名”的外部函数；</li><li>同样也不要将你要保护的数据作为指针或引用返回函数外部；</li><li>当你有多个锁要锁的时候，需要注意死锁；</li><li>如果你提供一个类型需要保证线程安全，确保你在设计api的时候精心考量；</li><li>控制锁的粒度，避免一些耗时的无必要的操作放在mutex保护范围内；</li></ul><h3><span id="死锁">死锁</span></h3><p>当你试图获取一个以上的锁的时候，如果姿势不对就可能产生死锁。解决死锁的通用的方法是，在所有需要同时获得多个锁的地方都按照一样的顺序去获取锁。当你需要同时获取两个锁的时候，<code>std::lock</code>可以帮你避免死锁的问题。</p><p>但是如果你的锁是在不同地方分别获得的，你还是有可能死锁。</p><p>关于如何避免死锁，有一些通用的建议：</p><ul><li>避免在一个锁的内部嵌套另外一个锁；</li><li>不要在拥有一个锁的时候去调用其他方法，因为你不知道其他方法会做一些什么事情；</li><li>用固定的顺序去获取锁；</li><li>利用Lock Hierarchy，这个核心思想是保证固定顺序去获得锁。每一个锁都分配一个层次号，锁的获取顺序只能是从高层到底层。反向则不行。书中给的例子很好，值得好好去理解。</li><li>死锁并不一定发生在有锁的地方，任何需要等待其他线程的地方都可能发生死锁。</li></ul><h3><span id="控制锁的粒度">控制锁的粒度</span></h3><blockquote><p>In general, a lock should be held for only the minimun possible time needed to perform the required operations.</p></blockquote><p>不要多、不要少、够用最好。</p><h2><span id="其他保护共享数据的方法">其他保护共享数据的方法</span></h2><ul><li><code>static</code>初始化。C++11开始，<code>static</code>初始化变量保证是线程安全的。对于一些只需要初始化一次的静态变量使用。</li><li>利用<code>std::recursive</code>来避免一些可重入的情况，但是大部分情况需要可重入的锁意味着代码设计可能有问题。最好通过调整代码来避免这种情况。</li><li>利用<code>std::shared_lock</code>来提高性能，针对大部分情况都是读，只有少数情况下会去修改的数据。</li></ul>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;多个线程间共享数据会出现什么问题&quot;&gt;多个线程间共享数据会出现什么问题？&lt;/span&gt;&lt;/h2&gt;&lt;p&gt;如果所有的数据都是只读的，那么多线程之间同时访问是不会有问题的。但是如果有人要读的同时有人要改就会出现问题。因为并非所有操作都能在一步完成，一般的操作会
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="C++11" scheme="http://zhengyi.me/tags/C-11/"/>
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="并发编程" scheme="http://zhengyi.me/tags/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
  </entry>
  
  <entry>
    <title>《C++ Concurrency In Action》读书笔记 - 线程管理</title>
    <link href="http://zhengyi.me/2018/03/29/cpp-concurrency-in-action-reading-notes-thread-management/"/>
    <id>http://zhengyi.me/2018/03/29/cpp-concurrency-in-action-reading-notes-thread-management/</id>
    <published>2018-03-29T15:20:12.000Z</published>
    <updated>2018-05-22T13:58:55.266Z</updated>
    
    <content type="html"><![CDATA[<p>C++11标准中加入了对多线程编程的支持，主要添加了下面一些方面：</p><ul><li>定义了内存模型</li><li><code>&lt;thread&gt;</code>，引入<code>std::thread</code>来管理、控制线程。</li><li><code>&lt;atomic&gt;</code>，原子操作相关类。</li><li><code>&lt;mutex&gt;</code>，引入<code>mutex</code>，以及相关的类，用于锁等互斥操作。</li><li><code>&lt;condition_variable&gt;</code>，引入<code>condition_variable</code>以及相关类，用于线程间同步。</li><li><code>&lt;future&gt;</code>，引入<code>future</code>, <code>promise</code>以及相关的一些类，主要用于线程间同步和通信的一些机制。</li></ul><p>这篇主要介绍对于线程管理的相关话题，对书中的内容进行总结并适当扩展。</p><ul><li>如何创建一个线程</li><li>如何销毁一个线程</li><li><code>std::thread</code>的所有权(owenership)</li><li>如何控制线程数量</li><li>线程ID</li></ul><h2><span id="如何创建一个线程">如何创建一个线程</span></h2><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">template&lt; class Function, class... Args &gt; </span><br><span class="line">explicit thread( Function&amp;&amp; f, Args&amp;&amp;... args );</span><br></pre></td></tr></table></figure><p><code>std::thread</code>构造函数如上，它可以接受任何callable的类型，包括全局方法、成员方法、<code>std::function</code>、仿函数、lambda表达式等。并且后面可以带参数，用来传递给方法。</p><p>例子：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"></span><br><span class="line">void func1() &#123;&#125;</span><br><span class="line">class A &#123;</span><br><span class="line">public:</span><br><span class="line">    void func2()&#123;&#125;</span><br><span class="line">&#125;;</span><br><span class="line"></span><br><span class="line">struct B &#123;</span><br><span class="line">public:</span><br><span class="line">    void operator()() &#123; &#125;</span><br><span class="line">&#125;;</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">    A obja;</span><br><span class="line">    B objb;</span><br><span class="line">    A obja;</span><br><span class="line">    B objb;</span><br><span class="line">    std::thread t1(func1);          //全局方法</span><br><span class="line">    std::thread t2(&amp;A::func2, obja);//成员方法</span><br><span class="line">    std::thread t3(objb);           //functor</span><br><span class="line">    std::thread t4([]()&#123;&#125;);         //lambda</span><br></pre></td></tr></table></figure><p>注意事项：</p><ul><li><code>std::thread</code>对象一旦创建，线程马上就起来了，没有办法延迟启动。</li><li><code>std::thread</code>一旦起来以后没有办法通过api它杀掉，除非通过<code>native_handle</code>拿到平台相关的线程句柄进行操作。这个非C++提供而是操作系统提供。</li></ul><h3><span id="传参">传参</span></h3><p>启动线程的时候可以传递参数，传参的形式默认为拷贝，如果有类型转换则是在线程启动时进行。所以需要保证传递的参数不依赖于方法栈上的其他内存。</p><p>如果不满足于默认的按值拷贝，可以通过<code>std::ref</code>或<code>std::move</code>进行传引用或转成右值进行move操作。下面给出几个例子。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"></span><br><span class="line">void pass_by_val(int i) &#123;&#125;</span><br><span class="line">void pass_by_ref(int &amp;i) &#123;&#125;</span><br><span class="line">void pass_by_move(std::unique_ptr&lt;big_obj&gt; bigObj)&#123;&#125;</span><br><span class="line"></span><br><span class="line">    int i;</span><br><span class="line">    std::thread t1(pass_by_val, i);</span><br><span class="line">    std::thread t2(pass_by_ref, std::ref(i));</span><br><span class="line">    std::thread t3(pass_by_move, std::make_unique&lt;big_obj&gt;());</span><br></pre></td></tr></table></figure><p>注意事项：</p><ul><li><code>std::ref</code> 注意引用的生命周期和线程的生命周期的关系。</li></ul><h2><span id="如何销毁一个线程">如何销毁一个线程</span></h2><p>你没法销毁一个线程，你只能等它跑完或者让他在后台运行并且把其管理权移交给C++运行库。</p><p>下面介绍一组和线程结束相关的api：</p><ul><li><code>bool jionable()</code>： 如果是默认线程(即<code>std::thread t;</code>)则是<code>false</code>。只要一个线程被<code>join</code>过一次以后则变为<code>false</code>，即使一个线程已经结束了，但是没有被<code>join</code>过，还是会返回<code>true</code>。</li><li><code>void join()</code>。等待线程结束运行，一个线程只能被调用一次，如果在<code>jioinable</code>为<code>false</code>的情况下调用，会直接抛出<code>std::system_error</code>。</li><li><code>void detach()</code>。将线程放到后台运行，并且将管理权转给C++运行库。</li></ul><p>注意事项：</p><ul><li>一个线程在析构前必须调用<code>join</code>或者<code>detach</code>来显示的处理它的生命周期，否则的话会析构时直接抛出异常。</li><li><code>join</code>本身并非线程安全，如果多个线程在没有保护的情况下同时<code>join</code>同一个<code>std::thread</code>会<code>undefined behavior</code></li></ul><h2><span id="stdthread的所有权owenership"><code>std::thread</code>的所有权(owenership)</span></h2><blockquote><p>No two std::thread objects may represent the same thread of execution; std::thread is not CopyConstructible or CopyAssignable, although it is MoveConstructible and MoveAssignable.<br><em><a href="http://en.cppreference.com/w/cpp/thread/thread" target="_blank" rel="external">http://en.cppreference.com/w/cpp/thread/thread</a></em></p></blockquote><p><code>std::thread</code> 只能move不能被拷贝，所以如果想要把<code>std::thread</code>放进容器的话必须确保是右值。直接构造出来或者用<code>std::move</code>进行转换都可以。</p><p>比如下面这样：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line">void calc_something(int i)&#123; std::cout &lt;&lt; i; &#125;</span><br><span class="line"></span><br><span class="line">   std::vector&lt;std::thread&gt; thread_vec;</span><br><span class="line">   for (int i = 0 ; i &lt; 3; i++)</span><br><span class="line">   &#123;</span><br><span class="line">       std::thread t(calc_something, i);</span><br><span class="line">       thread_vec.push_back(std::move(t));                   // use std::move</span><br><span class="line">       thread_vec.push_back(std::thread(calc_something, i)); // 直接构建为右值</span><br><span class="line">       thread_vec.emplace_back(calc_something, i);           // 用emplace_back</span><br><span class="line">   &#125;</span><br><span class="line">   </span><br><span class="line">   for(auto &amp; t : thread_vec)</span><br><span class="line">   &#123;</span><br><span class="line">       if (t.joinable()) t.join();</span><br><span class="line">   &#125;</span><br></pre></td></tr></table></figure><h2><span id="如何控制线程数量">如何控制线程数量</span></h2><p>线程数量并非越多越好，数量太多会导致CPU的频繁上下文切换，反而会适得其反。<code>std::thread::hardware_concurrency</code>静态方法可以获得。</p><blockquote><p>Returns the number of concurrent threads supported by the implementation. The value should be considered only a hint.<br><em><a href="http://en.cppreference.com/w/cpp/thread/thread/hardware_concurrency" target="_blank" rel="external">http://en.cppreference.com/w/cpp/thread/thread/hardware_concurrency</a></em></p></blockquote><p>但是这个数量仅供参考，因为依赖于不同编译器和平台的实现。有可能会返回0，表示这个数量未定义，也就是说不知道在这个硬件上有多少个并发线程可以执行。</p><h2><span id="线程id">线程ID</span></h2><p>通过 <code>std::thread::id  std::thraed::get_id()</code>可以拿到一个线程的id。这个id主要的用途是用来打印log和作为关系容器的key。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">std::map&lt;std::thread::id, std::thread&gt; thread_map;</span><br><span class="line">for (int i = 0 ; i &lt; 3; i++)</span><br><span class="line">&#123;</span><br><span class="line">    std::thread t(calc_something, i);</span><br><span class="line">    thread_map[t.get_id()] = std::move(t);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">


        &lt;p&gt;C++11标准中加入了对多线程编程的支持，主要添加了下面一些方面：&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;定义了内存模型&lt;/li&gt;
&lt;li&gt;&lt;code&gt;&amp;lt;thread&amp;gt;&lt;/code&gt;，引入&lt;code&gt;std::thread&lt;/code&gt;来管理、控制线程。&lt;/li&gt;
&lt;li&gt;
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="C++11" scheme="http://zhengyi.me/tags/C-11/"/>
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="并发编程" scheme="http://zhengyi.me/tags/%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B/"/>
    
  </entry>
  
  <entry>
    <title>TCP协议学习 - 1 / TCP协议初窥</title>
    <link href="http://zhengyi.me/2018/03/20/learning-tcp-01/"/>
    <id>http://zhengyi.me/2018/03/20/learning-tcp-01/</id>
    <published>2018-03-20T14:12:22.000Z</published>
    <updated>2018-05-22T13:58:55.266Z</updated>
    
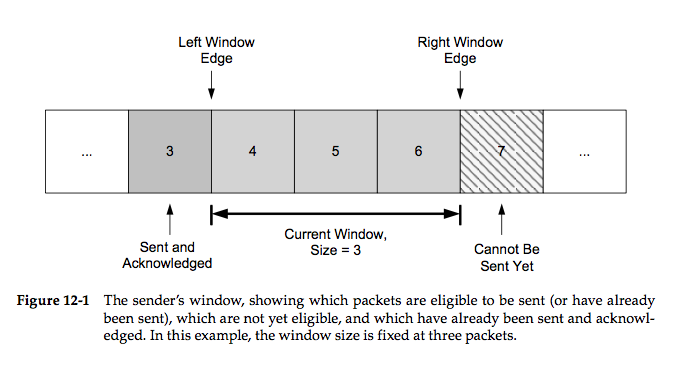
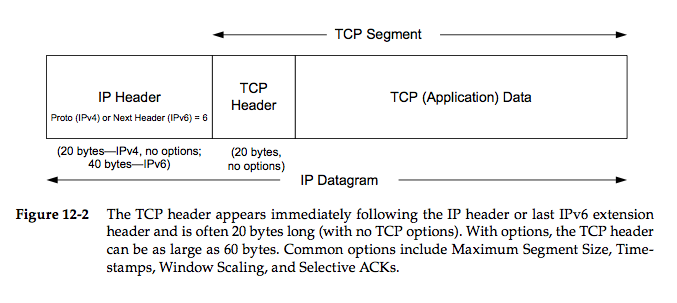
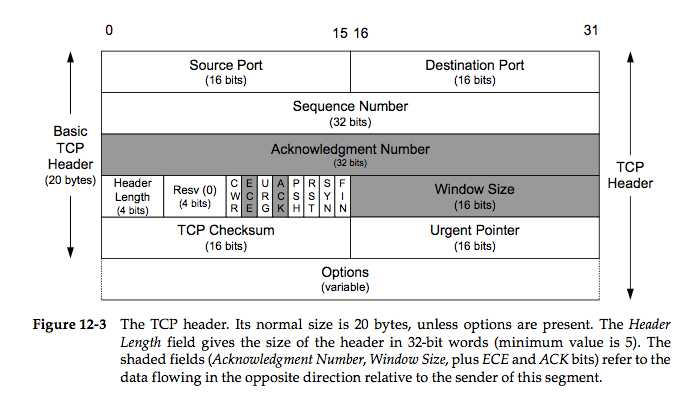
    <content type="html"><![CDATA[<p>这个系列主要学习TCP协议，主要以阅读<a href="https://book.douban.com/subject/3571433/" target="_blank" rel="external">TCP/IP Illustrated, Volume 1 (2nd Edition)</a>和<a href="https://book.douban.com/subject/1088054/" target="_blank" rel="external">TCP/IP详解 卷1：协议</a>为主，并结合一些网上的资料。</p><p>这章标题为：TCP: The Transmission Control Protocol (Preliminaries)，主要是介绍一些TCP协议要解决的问题，以及大致的设计思路。具体的技术细节要在之后的章节进行详细的阐述。</p><h2><span id="简单设计一个协议">简单设计一个协议</span></h2><p>TCP协议下层的协议都不是“可靠”的，它们不保证传输的可靠性。所以要建立一个可靠地传输协议需要克服一下几个问题：</p><ol><li>包内部的数据错误(packet bit errrors)。在传输的过程中有可能导致传输的数据中的bit有错误。</li><li>丢包(packet erasure)</li><li>包的顺序不对(packet reordering)。</li><li>重复的包(packet duplication)。</li></ol><p>解决1和2可以用重传的机制，发送端发送包给接收端，接收端接收到以后确认没有错误返回一个确认信息（ACK/acknowledge）。如果发送端没有及时收到确认信息，则重传直到收到确认信息。</p><p>解决3和4可以假如序列号（sequence number），这样接收端就可以直到收到的包的顺序和是否重复。</p><p>上面的两个简单地解决方案可以解决我们提到的四个问题。但是这个方案本身还有一些悬而未决和不足的地方：</p><ol><li>发送端应该等待多久才认为是超时了？（这个问题比较复杂，会在十四章详述）</li><li>如果接收端发出来的ACK信息丢失了怎么办？（可以归类为第一个问题）</li><li>如果接收端收到包但是有错误怎么处理？（假如checksum校验，如果发现有错误则不确认，即可归类为第一个问题）</li><li>这个方案只能一个一个包发送，大部分情况下发送端处于空闲状态，效率低下。（下面会引入窗口概念）</li></ol><h2><span id="窗口和滑动">窗口和滑动</span></h2><p>解决上述方案中的第四个问题，我们可以引入一个窗口的概念。一次不是只发送一个包，而是发送一组包。可以想象成一个窗口，当前面发送的包已经被确认以后，则可以将窗口往下进行滑动去发送更多的包。窗口的基本意思可以看书上的插图，比较直观。</p><p><img src="/img/learning_tcp/sliding-windows.png" alt="Sliding Widnows"></p><p>可以看到窗口的大小会直接影响到同时发出多少个包，这个大小的设置就直接影响到了接收端和中途的网络设备。如果太大的话可能会导致接收端无法处理，也可能导致中途的网络设备无法处理造成丢包，从而影响发送效率。太小的话则无法很好地充分利用网络资源和接收端的资源。</p><p>这里会引入两个概念。流量控制（flow control）和阻塞控制（congestion control）。</p><p>接收端可以根据自己的情况告诉发送端自己合适的窗口大小是多少，一般通过ACK包一起发送回去。这个属于流量控制，又称显式控制（explicit signaling）。</p><p>网络设备的拥堵情况则没有办法通过显式的控制，而是需要通过一些算法来计算出来一个比较合适的窗口大小。这个可以称为隐式控制（implicit signaling）。这个会在十五章里面详细讨论。</p><p><strong>如何设置超时？</strong></p><p>对于每一个包的传输时间（round-trip-time），即从发送到收到确认的时间，我们可以知道。我们能通过一些统计来估算出一个大概的时间当做超时。很显然平均值不是一个很好的选择，因为如果用平均值的话可能会有很多请求直接被超时了。如何设置超时也是一个需要深入讨论的问题，会在十四章中进行讨论。</p><h2><span id="介绍tcp">介绍TCP</span></h2><p>TCP协议是一个面向连接（connection-oriented）的协议，这个意思是两个应用必须先建立连接，然后才能进行通行。</p><p>TCP是一个可靠的协议，它具备以下几个特点确保其其可靠性：</p><ul><li>强制checksum校验，保证数据传输是对的。如果传输的数据块太大则需要引入其他的中间层来保证。</li><li>有timer来保证超时会重发。</li><li>有ACK来保证接收端确认收到包。并且ACK的确认是累加性的，如果接收端收到了x+2 返送了ACK x+3，但ACK x+3丢了。下次接收端接收到x+3的时候会返回ACK x+4，这样就可以避免x+2重传。</li><li>TCP有序列号来解决乱序和重复包的问题。</li><li>TCP为全双工，两边都可以进行传输。</li></ul><h2><span id="tcp头部和封装">TCP头部和封装</span></h2><p>插两张图</p><p><img src="/img/learning_tcp/tcp-header1.png" alt="TCP Header 1"></p><p><img src="/img/learning_tcp/tcp-header.png" alt="TCP Header 2"></p><p>图中可以看到有8个比特位用来控制TCP的一些flag，用于不同的请求。可能会多于一个比特位被置成1。</p>]]></content>
    
    <summary type="html">


        &lt;p&gt;这个系列主要学习TCP协议，主要以阅读&lt;a href=&quot;https://book.douban.com/subject/3571433/&quot; target=&quot;_blank&quot; rel=&quot;external&quot;&gt;TCP/IP Illustrated, Volume 1 (2nd Ed
      
    
    </summary>
    
    
      <category term="TCP" scheme="http://zhengyi.me/tags/TCP/"/>
    
      <category term="网络" scheme="http://zhengyi.me/tags/%E7%BD%91%E7%BB%9C/"/>
    
  </entry>
  
  <entry>
    <title>std::shared_ptr&lt;void&gt;的工作原理</title>
    <link href="http://zhengyi.me/2017/12/28/how-shared-ptr-void-works/"/>
    <id>http://zhengyi.me/2017/12/28/how-shared-ptr-void-works/</id>
    <published>2017-12-28T15:13:59.000Z</published>
    <updated>2018-02-23T14:45:09.000Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="前戏">前戏</span></h2><p>先抛出两个问题</p><ul><li>如果<code>delete</code>一个指针，但是它真实的类型和指针类型不一样会发生什么？</li><li>是谁调用了析构函数？ </li></ul><p>下面这段代码会发生什么有趣的事情？</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br></pre></td><td class="code"><pre><span class="line">// delete_diff_type.cpp</span><br><span class="line">#include &lt;iostream&gt;</span><br><span class="line"></span><br><span class="line">using namespace std;</span><br><span class="line"></span><br><span class="line">class Foo</span><br><span class="line">&#123;</span><br><span class="line">public:</span><br><span class="line">    Foo() &#123; cout &lt;&lt; &quot;Foo()&quot; &lt;&lt; endl; &#125;</span><br><span class="line">    ~Foo() &#123; cout &lt;&lt; &quot;~Foo()&quot; &lt;&lt; endl; &#125;</span><br><span class="line">&#125;;</span><br><span class="line"></span><br><span class="line">class FakeFoo</span><br><span class="line">&#123;</span><br><span class="line">public:</span><br><span class="line">    FakeFoo() &#123; cout &lt;&lt; &quot;FakeFoo()&quot; &lt;&lt; endl; &#125;</span><br><span class="line">    ~FakeFoo() &#123; cout &lt;&lt; &quot;~FakeFoo()&quot; &lt;&lt; endl; &#125;</span><br><span class="line">&#125;;</span><br><span class="line"></span><br><span class="line">int main(int argc, const char * argv[]) &#123;</span><br><span class="line">    </span><br><span class="line">    void* vptr = new Foo();</span><br><span class="line">    delete vptr;    // warning</span><br><span class="line">    </span><br><span class="line">//    FakeFoo* ffptr = static_cast&lt;FakeFoo*&gt;(new Foo()); // error</span><br><span class="line">    FakeFoo* ffptr = reinterpret_cast&lt;FakeFoo*&gt;(new Foo());</span><br><span class="line">    delete ffptr;</span><br><span class="line">    </span><br><span class="line">    Foo* fptr = new Foo();</span><br><span class="line">    delete fptr;</span><br><span class="line">    </span><br><span class="line">    return 0;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">输出:</span><br><span class="line">Foo()</span><br><span class="line">Foo()</span><br><span class="line">~FakeFoo()</span><br><span class="line">Foo()</span><br><span class="line">~Foo()</span><br></pre></td></tr></table></figure><p>看一下汇编代码可以看到<code>main</code>函数主要做了下面这几件事</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line">; symbol stub for: operator new(unsigned long)</span><br><span class="line">; Foo::Foo at delete_diff_type.cpp:8</span><br><span class="line">; symbol stub for: operator delete(void*)</span><br><span class="line"></span><br><span class="line">; symbol stub for: operator new(unsigned long)</span><br><span class="line">; Foo::Foo at delete_diff_type.cpp:8</span><br><span class="line">; FakeFoo::~FakeFoo at delete_diff_type.cpp:16</span><br><span class="line">; symbol stub for: operator delete(void*)</span><br><span class="line"></span><br><span class="line">; symbol stub for: operator new(unsigned long)</span><br><span class="line">; Foo::Foo at delete_diff_type.cpp:8</span><br><span class="line">; Foo::~Foo at delete_diff_type.cpp:9</span><br><span class="line">; symbol stub for: operator delete(void*)</span><br></pre></td></tr></table></figure><p>从汇编中可以看出，构造造函数和析构函数是编译器根据指针的类型生成的调用代码。而且编译器是不允许没有继承关系的指针之间进行转换的，<code>void*</code> 是个例外，只要不作死用<code>reinterpret_cast</code>把指针转换成不相关的类型是不会有问题的。</p><p>所以上面两个问题大概就有答案了。<code>delete</code>语句会至少产生两个动作，一个是调用指针对应类型的析构函数，然后去调用<code>operator delete</code>释放内存。所以如果<code>delete</code>的指针和其指向的真实类型不一样的时候，编译器只会调用指针类型的析构函数，这也就为什么基类的析构函数需要声明称虚函数才能够保证<code>delete</code>基类指针的时候子类析构函数能够被正确的调用。<br><code>operator delete</code>是都会被调用到的，所以指针指向的那块内存是能够“正常的”被释放掉用。</p><h2><span id="stdshared_ptrltvoidgt-的行为"><code>std::shared_ptr&lt;void&gt;</code> 的行为</span></h2><p>那么这个跟<code>std::shared_ptr&lt;void&gt;</code> 有什么关系呢？</p><p>先看一段代码</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line">#include &lt;iostream&gt;</span><br><span class="line"></span><br><span class="line">using namespace std;</span><br><span class="line"></span><br><span class="line">class Foo</span><br><span class="line">&#123;</span><br><span class="line">public:</span><br><span class="line">    Foo() &#123; cout &lt;&lt; &quot;Foo()&quot; &lt;&lt; endl; &#125;</span><br><span class="line">    ~Foo() &#123; cout &lt;&lt; &quot;~Foo()&quot; &lt;&lt; endl; &#125;</span><br><span class="line">&#125;;</span><br><span class="line"></span><br><span class="line">int main(int argc, const char * argv[]) &#123;</span><br><span class="line">    shared_ptr&lt;void&gt; vptr = shared_ptr&lt;Foo&gt;(new Foo);</span><br><span class="line">    return 0;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输出：</span><br><span class="line">Foo()</span><br><span class="line">~Foo()</span><br></pre></td></tr></table></figure><p>与第一段代码中类似，不过把<code>void*</code>换成了<code>std::shared_ptr&lt;void&gt;</code>，那么<code>shared_ptr&lt;void&gt;</code>为什么能够调用到正确的析构函数呢？一定是<code>shared_ptr</code>里面搞了什么鬼。</p><h2><span id="stdshared_ptrltvoidgt-为啥能正常工作"><code>std::shared_ptr&lt;void&gt;</code> 为啥能正常工作</span></h2><p>那么就看看源代码看看到底为啥这货能够工作，下面是<em>libcxx</em>中<code>shared_ptr</code>的部分源码，把关键的部分抠出来了。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br></pre></td><td class="code"><pre><span class="line">/** C1. shared_ptr 构造函数 **/</span><br><span class="line"></span><br><span class="line">template&lt;class _Tp&gt;</span><br><span class="line">template&lt;class _Yp&gt;</span><br><span class="line">shared_ptr&lt;_Tp&gt;::shared_ptr(_Yp* __p,</span><br><span class="line">                            typename enable_if&lt;is_convertible&lt;_Yp*, element_type*&gt;::value, __nat&gt;::type)</span><br><span class="line">    : __ptr_(__p)</span><br><span class="line">&#123;</span><br><span class="line">    unique_ptr&lt;_Yp&gt; __hold(__p);</span><br><span class="line">    typedef typename __shared_ptr_default_allocator&lt;_Yp&gt;::type _AllocT;</span><br><span class="line">    typedef __shared_ptr_pointer&lt;_Yp*, default_delete&lt;_Yp&gt;, _AllocT &gt; _CntrlBlk;</span><br><span class="line">    __cntrl_ = new _CntrlBlk(__p, default_delete&lt;_Yp&gt;(), _AllocT());</span><br><span class="line">    __hold.release();</span><br><span class="line">    __enable_weak_this(__p, __p);</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">/** C2. shared_ptr 拷贝构造 **/</span><br><span class="line">template&lt;class _Tp&gt;</span><br><span class="line">inline</span><br><span class="line">shared_ptr&lt;_Tp&gt;::shared_ptr(const shared_ptr&amp; __r) _NOEXCEPT</span><br><span class="line">    : __ptr_(__r.__ptr_),</span><br><span class="line">      __cntrl_(__r.__cntrl_)</span><br><span class="line">&#123;</span><br><span class="line">    if (__cntrl_)</span><br><span class="line">        __cntrl_-&gt;__add_shared();</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">/** C3. shared_ptr::__cntrl_ 类型 **/</span><br><span class="line">__shared_weak_count* __cntrl_;</span><br><span class="line"></span><br><span class="line">/** C4. shared_ptr 析构函数 **/</span><br><span class="line"></span><br><span class="line">template&lt;class _Tp&gt;</span><br><span class="line">shared_ptr&lt;_Tp&gt;::~shared_ptr()</span><br><span class="line">&#123;</span><br><span class="line">    if (__cntrl_)</span><br><span class="line">        __cntrl_-&gt;__release_shared();</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">/** C5. __shared_weak_count::__release_shared **/</span><br><span class="line"></span><br><span class="line">bool __release_shared() _NOEXCEPT &#123;</span><br><span class="line">    if (__libcpp_atomic_refcount_decrement(__shared_owners_) == -1) &#123;</span><br><span class="line">    __on_zero_shared();</span><br><span class="line">    return true;</span><br><span class="line">    &#125;</span><br><span class="line">    return false;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">/** C6. __shared_ptr_pointer::__release_shared **/</span><br><span class="line">template &lt;class _Tp, class _Dp, class _Alloc&gt;</span><br><span class="line">/* 重点 !!! virtual !!! */</span><br><span class="line">void</span><br><span class="line">__shared_ptr_pointer&lt;_Tp, _Dp, _Alloc&gt;::__on_zero_shared() _NOEXCEPT</span><br><span class="line">&#123;</span><br><span class="line">    // __data__ 是 内部工具类__compressed_pair</span><br><span class="line">    // __data_.first().second()是 deleter</span><br><span class="line">    // __data_.first().first() 是 shared_ptr&lt;T&gt; 中T类型的指针</span><br><span class="line">    __data_.first().second()(__data_.first().first());</span><br><span class="line">    __data_.first().second().~_Dp();</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">/** C7. default deleter **/</span><br><span class="line"></span><br><span class="line">template &lt;class _Tp&gt;</span><br><span class="line">struct _LIBCPP_TEMPLATE_VIS default_delete &#123;</span><br><span class="line">    // ... 此处省略若干行</span><br><span class="line">  void operator()(_Tp* __ptr) const _NOEXCEPT &#123;</span><br><span class="line">    delete __ptr;</span><br><span class="line">  &#125;</span><br><span class="line">&#125;;</span><br></pre></td></tr></table></figure><p>不要慌，给你慢慢道来。</p><p>这个故事简单得说是这样的：</p><ul><li>每一个<code>shared_ptr</code> 内部有一个<code>control block</code>，里面会存放一个要维护的指针，一个计数，一个删除器(<code>deleter</code>)，一个分配(<code>allocator</code>)。这里我们要关心的是删除器。顾名思义，它是用来删除指针的。</li><li><code>shared_ptr</code>中的 有一个<code>__cntrl_</code>即<code>control block</code>。字段的类型是<code>__shared_weak_count</code>指针，这个类是一个非模板类。<code>shared_ptr&lt;T&gt;</code>创建的<code>control block</code>的类型是一个类模板<code>template &lt;class _Tp, class _Dp, class _Alloc&gt; __shared_ptr_pointer</code>继承自<code>__shared_weak_count</code>。 见<strong>代码C3</strong>。</li><li>当创建一个新的<code>shared_ptr</code>的时候，构建一个新的<code>control block</code>。见<strong>代码C1</strong>。</li><li>当一个<code>shared_ptr</code> A赋值或者拷贝构造给另一个<code>shared_ptr</code>B的时候（当然是在类型能够转换的前提下），B会把A的<code>__cntrl_</code>拷一份，同时将其引用加一。注意，这个时候拷贝的是指针，<code>__cntrl_</code>还是指向最初创建的那个对象。见<strong>代码C2</strong>。</li><li>当<code>shared_ptr</code>被析构或者重置的时候会调用<code>__cntrl_-&gt;__release_shared()</code>。见<strong>代码C4</strong>。</li><li><code>__cntrl_-&gt;__release_shared()</code>如果发现当前的计数为-1的时候，调用<code>__on_zero_shared()</code>。见<strong>代码C5</strong>。</li><li><code>__on_zero_shared</code>是一个虚方法，那么它就会调用到最初创建的<code>__shared_ptr_pointer</code>的实现。</li><li><code>__shared_ptr_pointer</code>的实现中是有完整的类型和删除器的信息的。见<strong>代码C6</strong>。</li><li>默认的删除器很简单的执行了<code>delete __ptr</code>操作，因为类型是已知的所以能够正确的调用到析构函数。见<strong>代码C7</strong>。</li></ul><h2><span id="这种实现方式给shared_ptr带来额外好处">这种实现方式给<code>shared_ptr</code>带来额外好处</span></h2><p><em>Effective C++</em>  条款07告诉我们“要为多态基类声明 virtual 析构函数”。当然我认为建议依然有效，但是用了<code>shared_ptr</code>以后带来的一个额外好处就是即便你的析构函数忘记写成<code>virtual</code>也能帮你正确的调用析构函数。</p>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;前戏&quot;&gt;前戏&lt;/span&gt;&lt;/h2&gt;&lt;p&gt;先抛出两个问题&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;如果&lt;code&gt;delete&lt;/code&gt;一个指针，但是它真实的类型和指针类型不一样会发生什么？&lt;/li&gt;
&lt;li&gt;是谁调用了析构函数？ &lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="C++11" scheme="http://zhengyi.me/tags/C-11/"/>
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="C++" scheme="http://zhengyi.me/tags/C/"/>
    
      <category term="源码阅读" scheme="http://zhengyi.me/tags/%E6%BA%90%E7%A0%81%E9%98%85%E8%AF%BB/"/>
    
  </entry>
  
  <entry>
    <title>[学习笔记] Udacity - Responsive Web Design Fundamentals?</title>
    <link href="http://zhengyi.me/2016/10/05/udacity-responsive-web-design-notes/"/>
    <id>http://zhengyi.me/2016/10/05/udacity-responsive-web-design-notes/</id>
    <published>2016-10-05T13:23:38.000Z</published>
    <updated>2016-10-05T13:59:23.000Z</updated>
    
    <content type="html"><![CDATA[<p>这门课程(<a href="https://www.udacity.com/course/responsive-web-design-fundamentals--ud893" target="_blank" rel="external">Responsive Web Design Fundamentals</a>)主要介绍了关于响应式设计的基础概念，常用的技巧，常用的设计模式以及如何对网站进行优化的一些技巧。</p><p>这个课程主要是提供一些思路，涉及到技术的部分也只是介绍了最基本用法，并不会深入某个技术去展开。通过这个课程的学习，我们应该能够对响应式设计有一个基本的了解，能够知道在设计响应式的页面时需要如何做和需要注意的一些地方。</p><p>课程的大纲如下，比较基础，课程还有挺多的练习，通过练习能够掌握一些基本的用法。</p><p><img src="/img/Udacity-RWD-Mindmap.png" alt="Course Structure"></p><h2><span id="为什么要响应式设计why-responsive">为什么要响应式设计？(Why Responsive?)</span></h2><p>响应式设计（Responsive Web Design，通常缩写RWD）是一种网页设计的技术，让网站在不同的设备上能够良好的显示。这个“良好的显示”是指能够给浏览网页者一个好的的体验。在移动设备普及前，一个网站只需要在一定程度上考虑不同尺寸即可，但是移动设备的普及，会引入一些很小尺寸的屏幕而且比例也不确定。这就需要响应式设计。</p><p><anchor>响应式设计除了是一门技术以外</anchor>，更多的是一门艺术，如何安排在不同尺寸上的显示方式很大程度上是设计相关的东西而不是技术相关的东西。</p><p><strong>移动优先</strong></p><p>移动优先的设计方式是指在设计的时候从移动端先开始设计，然后再慢慢的往大尺寸去增强。这样的设计方式能够帮助设计者更好的去思考对于一个网页来说什么是最重要的内容，如何把这些内容合理的摆放才能达到效果。</p><h2><span id="从小开始starting-small">从小开始（Starting Small）</span></h2><p>既然涉及到不同的设备，那么关于尺寸的一些概念就需要在这里先搞清楚。</p><ul><li>设备分辨率（Hardware Resolution/Pixel）</li><li>设备独立像素（Device Independent Pixel）</li><li>CSS像素（CSS Pixel）</li><li>Viewport</li></ul><h3><span id="设备分辨率">设备分辨率</span></h3><p>这个很好理解，指得是设备本身的实际分辨率，也就是说一个设备上事实上分布的像素点的个数。</p><h3><span id="设备独立像素">设备独立像素</span></h3><p>设备独立像素是基于某一个系统的坐标系中的一个物理度量单位，系统会将设备独立的像素转换成设备上的实际像素。<sup>[1]</sup></p><p>举个例子，iPhone 3G和iPhone 4S的物理尺寸都是3.5英寸，它们的设备分辨率分别是320 x 480和640 x 960。但是它们的设备独立分辨率是一样的，都是320 x 480<sup>[2]</sup><sup>[3]</sup>。</p><p>课程中给出了一个很形象的图</p><p><img src="/img/Udacity-RWD-DIP-vs-Hardware-Pixel.png" alt="Compare DIP and Hardware Pixels"></p><h3><span id="css像素">CSS像素</span></h3><p>在浏览器没有缩放的情况下，1个CSS像素对应1个设备独立像素。</p><h3><span id="viewport">Viewport</span></h3><p>Viewport指的是用户在设备上的可视区域，在移动设备上这个可视区域往往比网页上的区域小。所以在老的移动浏览器上，会把页面根据实际的大小渲染出来，如果那个尺寸比手机大，用户则需要通过移动，放大和缩小来进行操作。</p><p>移动版Safari引入了“viewport meta”标签来允许开发控制viewpoint的尺寸和缩放比例，虽然这个不是标准，但是大多数的浏览器目前支持这种做法。</p><p>典型的viewport的使用方法如下，将这个<code>meta</code>标签加到<code>&lt;head&gt;</code>中：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">&lt;meta name=&quot;viewport&quot; content=&quot;width=device-width, initial-scale=1&quot;&gt;</span><br></pre></td></tr></table></figure><p>关于Viewport的内容还有很多，我会另起一篇文章进行深入的学习。</p><h3><span id="从小开始">从“小”开始</span></h3><p>这里的从“小”开始指的是从小屏幕开始设计开发，这个跟上面提到的移动优先的概念是吻合的。</p><div style="display: flex"><br>    <div style="width:50%"><br>    <img src="/img/Udacity-RWD-Big-to-Small.png" alt="Udacity-RWD-Big-to-Small"><br>    </div><br>    <div style="width:50%"><br>    <img src="/img/Udacity-RWD-Small-to-Big.png" alt="Udacity-RWD-Small-to-Big"><br>    </div><br></div><p>作者给出了两个图来解释，我觉得挺形象的。从小到大设计和从大到小设计就如同图中的漏斗一样。从大到小，很可能会误把一些有用的内容给过滤掉，而从小到大则不会。</p><p>另外从小开始设计还能够一开始就考虑到性能相关的问题。</p><h2><span id="逐步构建building-up">逐步构建（Building Up）</span></h2><p>构建一个响应式的引用主要需要用到一下几个概念和技术：</p><ul><li>Media Query</li><li>Breakpoint</li><li>Flexbox</li></ul><h3><span id="media-query">Media Query</span></h3><p>Media query 是实现响应式编程使用的最重要的技术，这个是在CSS中根据某一些条件包含一些样式。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">@media screen and (min-width: 480px) &#123;</span><br><span class="line">    body &#123;</span><br><span class="line">        background-color: lightgreen;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br><span class="line">Try it Yourself »</span><br><span class="line">The</span><br></pre></td></tr></table></figure><p>这个是media query的语法定义，举个例子，比如我们想在viewport大于400px时将背景颜色改成红色。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">@media screen and (min-width: 400px) &#123;</span><br><span class="line">    body &#123;</span><br><span class="line">        background-color: red;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3><span id="breakpoint">Breakpoint</span></h3><p>使用了media query以后会存在一个或多个点是的某一些样式被引用进来，比如上面的那个media query中400px就称为一个breakpoint（断点）。</p><p>断点的设置也是根据设计而来，没有严格的要求。我们可以在一个断点进行大的UI调整，也可以在断点进行一些细微的调整。这个也是一门艺术，而不是一个技术。</p><p>视频中提到了两个断点的例子，我觉得可以仔细观察一下：</p><ul><li><a href="http://skinnyties.com/" target="_blank" rel="external">http://skinnyties.com/</a></li><li><a href="http://cnn.com" target="_blank" rel="external">http://cnn.com</a></li></ul><h3><span id="flexbox">Flexbox</span></h3><p>Flexbox是flexible box的缩写，是2009年W3C提出了一种新的布局解决方案。目前已经在所有的浏览器上得到支持<sup>[5]</sup>。Flex<br>布局的核心思想是让flex容器有能力去修改其子元素的宽度，高度还有顺序从而更好的使用可用的空间。</p><p>课程中提到的不同响应式设计的模式都是使用flex技术实现的。</p><h2><span id="common-responsive-patterns">Common Responsive Patterns</span></h2><p>课程中提供了四种比较通用的响应式模式，这几种模式只是提供了一种思路。可以根据具体的设计组合使用。</p><h3><span id="column-drop">Column Drop</span></h3><p><img src="/img/Udacity-RWD-Column-Drop.png" alt="Column Drop"></p><h3><span id="mostly-fluid">Mostly Fluid</span></h3><p><img src="/img/Udacity-RWD-Mostly-Fluid.png" alt="Mostly Fluid"></p><h3><span id="layout-shifter">Layout Shifter</span></h3><p><img src="/img/Udacity-RWD-Layout-Shifter.png" alt="Layout Shifter"></p><h3><span id="off-canvas">Off Canvas</span></h3><p><img src="/img/Udacity-RWD-Off-Canvas.png" alt="Off Canvas"></p><h2><span id="optimizations">Optimizations</span></h2><p>课程提供了几个在响应式设计的时候可以注意的优化点，包括图片、字体和表格。</p><h3><span id="图片">图片</span></h3><p>响应式的图片，不仅仅是要求图片的尺寸要正确，最关键的是要保证在不同的尺寸下图片显示出来的主体是一个合理的而不是只显示了一部分或者以不合理的缩放比例展示出来。在另一门<a href="https://www.udacity.com/course/responsive-images--ud882" target="_blank" rel="external">「Responsive Images」</a>有关于响应式图片的深入介绍。</p><h3><span id="字体">字体</span></h3><p>在适当的时候需要调整字体的大小从而使其能够更好地适应当前的尺寸。<br>另外，一行的字数也要控制在一个合理的而范围之内，就英语而言，每行65个字符是比较合适的</p><h3><span id="表格">表格</span></h3><p>表格在尺寸的屏幕上比较尴尬，因为表格的信息量比较大而且往往有比较多的列。对于表格我们可以采用一些策略：</p><ul><li>减少表格列，只显示最重要的信息。</li><li>将列展平，用行的形式显示列。</li><li>将表格放在一个container，将container的样式设置为<code>overflow-x: auto, width: 100%</code>。将滚动的区域控制在一个小范围内。</li></ul><h2><span id="references">References</span></h2><p>[1]: <a href="https://en.wikipedia.org/wiki/Device-independent_pixel" target="_blank" rel="external">Wikipedia - Device-independent pixel</a><br>[2]: <a href="http://www.phonearena.com/phones/compare/Apple-iPhone-4s,Apple-iPhone-3G/phones/5257%2C2962" target="_blank" rel="external">Apple iPhone 4s vs Apple iPhone 3G</a><br>[3]: <a href="http://viewportsizes.com/?filter=iphone" target="_blank" rel="external">Viewport Sizes</a><br>[4]: <a href="https://developer.mozilla.org/en-US/docs/Mozilla/Mobile/Viewport_meta_tag" target="_blank" rel="external">Mozilla - Using the viewport meta tag to control layout on mobile browsers</a><br>[5]: <a href="http://caniuse.com/#search=flexbox" target="_blank" rel="external">Can I use Flexbox</a></p>]]></content>
    
    <summary type="html">


        &lt;p&gt;这门课程(&lt;a href=&quot;https://www.udacity.com/course/responsive-web-design-fundamentals--ud893&quot; target=&quot;_blank&quot; rel=&quot;external&quot;&gt;Responsive Web Des
      
    
    </summary>
    
      <category term="编程工具" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E5%B7%A5%E5%85%B7/"/>
    
    
      <category term="Udacity" scheme="http://zhengyi.me/tags/Udacity/"/>
    
      <category term="前端" scheme="http://zhengyi.me/tags/%E5%89%8D%E7%AB%AF/"/>
    
      <category term="RWD" scheme="http://zhengyi.me/tags/RWD/"/>
    
      <category term="Design" scheme="http://zhengyi.me/tags/Design/"/>
    
  </entry>
  
  <entry>
    <title>去「界外」看看</title>
    <link href="http://zhengyi.me/2016/09/29/go-out-border/"/>
    <id>http://zhengyi.me/2016/09/29/go-out-border/</id>
    <published>2016-09-29T13:14:40.000Z</published>
    <updated>2016-10-05T13:18:00.000Z</updated>
    
    <content type="html"><![CDATA[<p>很多人的生活大部分时间都是处于公司-家的两点一线的状态，不知道你有没有过这样的经历。某一天，你开车开错路或者坐公交坐过站了，突然惊奇的发现就在你附近的一个地方跟你想象的不大一样，有时候还能够发现一些很好玩的地方。</p><p>某天晚上，在家附近吃完晚饭，突发奇想往从来都有去过的街的另一头散步走去。走出不到两公里，惊奇的发现原来离我家这么近的地方竟然还有一处迷你的公园。突然心生感慨，其实很多美好的东西可能就在你附近，只是你一直被一个隐形的边界限定住了你探索的脚步。</p><p>有一种说法是“旅游就是从一个你熟悉的地方跑到你一个别人熟悉的地方”。为什么有人喜欢旅游？因为在一个陌生的地方，人们往往能够发现一些不一样的地方，你去的地方离你越远可能这种差异性更强，能够给你带来的冲击也就越强。反过来，其他地方的人到你所生活的地方也同样会受到类似的冲击。在一个陌生的地方，人们的各个感官都处在兴奋、焦虑的状态，它们会极力得去吸取尽可能多的信息然后在脑子里飞速的运算。走在一个异国的路上，可能路边的一个垃圾桶、一个流浪汉、一个普通的招牌都能够吸引你驻足去观察，因为你从来没见过这样的东西。但如果，你在这个地方待上一段时间，你会发现你变得跟本地人一样，把自己的“感官”关闭了，不再抱有极大的好奇心去观察周遭的事物。因为你养成了习惯，习惯可以让你省去很多的思考，让你很轻松的去完成一件事情。比如说，你从地铁站出来不用思考是往左走还是往右走，你的习惯会把你很自然的带回家。</p><p>旅游只是一个简单的例子，除了旅游以外我们的生活中还有非常多的类似的例子。我认为在几乎所有你做的事情上，这种现象都是存在的。小到刷牙洗脸，大到公司决策，都或多或少的收到习惯的影响。</p><p>我们的大脑很聪明也很懒，它帮我们养成了很多的习惯，这样我们就不需要处处进行思考，很多时候跟着熟悉的感觉就能够完成一件事情了。大脑的聪明是很有必要的，在多数情况下能够让我们变得更轻松。但是，这种聪明也为我们设立了一个无形的边界，一个我们不留意可能都不会去注意到的一个边界。在这个边界内，我们是”安全”的，因为某些路径已经被多次证明过是可行的。</p><p>然而一条“安全”可行的路径不代表这条路径是最优的，即使在当下是最优的，也不代表它在外部条件变化的情况下依然是最优的。所以说这种安全是不可靠的，因为外界的条件不可能永远不变。而且习惯是有一定的惯性的，一个习惯你坚持的越久它的惯性就越大，你要改变它的难度及所带来的痛苦也就越大。</p><p>所以，我的结论是<strong>要需要经常去「界外」看看，让我们拥有随时改变路径的能力</strong>。</p><p>那么这个结论就引出了另外几个问题：</p><ol><li>作为一个身处于边界里面的人如何去发现自己的边界。都说要Think out of box，但是如何才能够发现自己的box？</li><li>发现以后到外面看看，肯定不能是简单地看看就完了。如何保持一个开放的心态去看待界外的事物？</li><li>如何才能够拓宽自己的边界？</li></ol><p>这几个问题，容我再想想。</p><center><em>== end of  file ==</em></center>]]></content>
    
    <summary type="html">


        &lt;p&gt;很多人的生活大部分时间都是处于公司-家的两点一线的状态，不知道你有没有过这样的经历。某一天，你开车开错路或者坐公交坐过站了，突然惊奇的发现就在你附近的一个地方跟你想象的不大一样，有时候还能够发现一些很好玩的地方。&lt;/p&gt;
&lt;p&gt;某天晚上，在家附近吃完晚饭，突发奇想往从来都有
      
    
    </summary>
    
    
      <category term="随想" scheme="http://zhengyi.me/tags/%E9%9A%8F%E6%83%B3/"/>
    
  </entry>
  
  <entry>
    <title>《Effective C++》读书笔记(5)</title>
    <link href="http://zhengyi.me/2016/09/06/effective-cpp-reading-notes-5/"/>
    <id>http://zhengyi.me/2016/09/06/effective-cpp-reading-notes-5/</id>
    <published>2016-09-06T13:15:57.000Z</published>
    <updated>2016-09-06T13:17:22.000Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="4-设计与声明">4. 设计与声明</span></h2><h3><span id="条款18让接口容易被使用不易被误用">条款18：让接口容易被使用，不易被误用</span></h3><blockquote><ul><li>好的借口很容易被正确使用，不容易被误用。你应该在你的所有接口中努力达成这些性质。</li><li>“促进正确使用”的办法包括接口的一致性，以及与内置类型的行为兼容。</li><li>“阻止误用”的办法包括建立新类型、限制类型上的操作，束缚对象值，以及消除客户的资源管理责任。</li><li>std::shared_ptr支持定制型删除器（custom deleter）。可防范DLL问题，可被用来自动解除互斥锁等等。</li></ul></blockquote><p>这个条款的思想其实适用于所有的编程语言，只要你写的代码需要被其他地方调用，你都需要考虑接口的易用性。即使不暴露，良好的接口设计也能够提高代码的可读性。作者提出的这几点只是在C++这个语言的基础上需要注意的一些小点，我认为设计一个良好的易用的接口，仅仅做到这几点还远远不够。</p><p><strong>接口一致性</strong></p><p>作者认为除非有充分的理由，否则最好让类型与内置的类型的行为尽量一致。这个可以降低使用者错误使用的概率。</p><p>我想补充的另外一点是，比如你提供一整套的接口，你需要让自己的接口相互保持一致的风格。包括但不仅限于：函数的命名风格、函数的行为尽量保持统一的风格。</p><p><strong>防止误用</strong></p><blockquote><p>任何接口如果要求客户必须记得做某件事情，就是有着“不正确使用”的倾向，因为客户可能会忘记做那件事。</p></blockquote><h3><span id="条款19设计class犹如设计type">条款19：设计class犹如设计type</span></h3><blockquote><p>Class 的设计就是type的设计。在定义一个新type之前，确保阅读了本条目的所有讨论主题。</p></blockquote><ul><li><strong>新type的对象应该如何被创建和销毁？</strong> 这个涉及到构造函数、构造函数以及operator new, operator delete, operator new[], operator delete[]。</li><li><strong>对象的初始化和对象的赋值该有什么样的差别？</strong>这个主要是要考虑构造函数和赋值操作符的行为。</li><li><strong>新type的对象如果被passed by value，意味着什么？</strong></li><li><strong>什么事新type的“合法值”？</strong>这点主要是要注意类型的成员变量和合法性检查。</li><li><strong>你的新type需要配合某个继承图系吗？</strong>如果你继承其他的类，需要考虑它们的函数virtual和non-virtual性。如果你的类可能被继承就需要注意你声明的函数——尤其是析构函数。</li><li><strong>你的新type需要什么样的转换？</strong>如果你的类型需要转换成其他的类型，需要考虑定义显式转换或者隐式转换的函数。</li><li><strong>什么样的操作符和函数对此新type而言是合理的？</strong>参考条款23，24，26.</li><li><strong>谁该取用新type的成员？</strong>这个可以使用者的角度来帮助你判断哪一些成员为public，哪个为protected。</li><li><strong>你的新type有多么一般化（generic）？</strong>如果很一般化，可以考虑设计一个class template。</li><li><strong>你真的需要一个新type吧？</strong>如果只是定义新的derived class以便为既有的class添加功能，那么说不定单纯定义一个或多个non-member函数或template更能够达到目标。</li></ul><p>这些问题并不是那么容易回答，在设计一个类型的时候尽量的去考虑这些问题能够更好地设计出一个易用合理的类型。</p><h3><span id="条款20宁以-pass-by-reference-to-const-替换-pass-by-value">条款20：宁以 pass-by-reference-to-const 替换 pass-by-value</span></h3><blockquote><ul><li>尽量以pass-by-reference-to-const 替换 pass-by-value。前者通常比较搞笑，并可以避免切割问题（slicing problem）。</li><li>以上规则并不适用于内置类型，以及STL的迭代器和函数对象。对于它们而言，pass-by-value往往比较适当。</li></ul></blockquote><p>C++默认的传递对象的方法是by-value的方式，当一个对象有很多的成员变量或者有很深的继承结构。那么对于这个对象的构造和销毁会带来很大的开销。这种情况下用pass by reference的方式就能够节省下这种开始。加上const是避免对传入的参数进行修改。</p><p>Pass by value的另一个问题就是对象切割的问题。如果一个子类对象以pass-by-value的形式传递到一个函数中来，那么它的对象将会被切割而失去子类特有的成员变量，而且同时也会失去多态性。pass-by-reference可以解决这个问题，因为reference往往以指针实现，所以截断对象也同时会保有多态性。</p><p>决定一个对象pass by value还是pass by reference的依据不是简单地类型的成员数量，还要考虑这个类型在拷贝的时候是否会做一些比较昂贵的操作。</p><p>有一些例外，即内置类型，以及STL的迭代器和函数对象。除此之外 pass-by-reference-to-const 优于 pass-by-value。</p><h3><span id="条款21必须返回对象是别妄想返回其reference">条款21：必须返回对象是，别妄想返回其reference</span></h3><blockquote><ul><li>绝不要返回pointer或reference指向一个local stack对象，或返回reference指向一个heap-allocated对象，或返回pointer或reference指向一个local static对象而有可能同时需要多个这样的对象。</li></ul></blockquote><p>返回一个pointer或者reference指向一个local stack对象明显是不合理的，因为local stack的生命周期在函数返回的时候就已经结束了，那么返回的那个指针或者引用将会指向一块被销毁的对象的内存。</p><p>指向一个heap-allocated的对象也是不合理的，因为你把销毁对象的任务移交给了使用函数的人，很多情况下人们会忘记。或者说所写的代码并没有让他有机会去销毁这个对象。比如说：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">const Rational&amp; operator * (const Rational&amp; lhs,</span><br><span class="line">const Rational&amp; rhs) &#123;</span><br><span class="line">...</span><br><span class="line">return *result;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">Rational w, x, y, z;</span><br><span class="line">w = x * y * z;</span><br></pre></td></tr></table></figure><p>只有在类似于单例的情况下，返回一个reference指向一个static的对象是合理的。比如说条款4中FileSystem的例子。</p><h3><span id="条款22将成员变量声明为private">条款22：将成员变量声明为private</span></h3><blockquote><ul><li>切记将成员变量声明为private，这可赋予客户访问数据的一致性、可细微划分访问控制、允诺约束条件获得保证，并提供class作者以充分的实现弹性。</li><li>protected 并不比public更具封装性。</li></ul></blockquote><p><strong>为什么public不好？</strong></p><p>public的成员变量破坏了类的封装性，它将成员直接暴露给客户，那么在未来修改字段的时候就会影响到使用者。</p><p><strong>为什么protected也不好？</strong></p><p>有一个原则，即<em>某些东西的封装性与“其内容改变时可能造成的代码破坏量”成反比。</em>如果从这个原则出发的话，protected虽然比public好，但是也并没有好太多。因为如果说你这个类型是对外暴露的，你不能阻止用户继承你这个类型，然后去访问其中的成员变量（C++暂时没有类似于final class的概念）。所以说protected的成员变量也不好。</p>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;4-设计与声明&quot;&gt;4. 设计与声明&lt;/span&gt;&lt;/h2&gt;&lt;h3&gt;&lt;span id=&quot;条款18让接口容易被使用不易被误用&quot;&gt;条款18：让接口容易被使用，不易被误用&lt;/span&gt;&lt;/h3&gt;&lt;blockquote&gt;
&lt;ul&gt;
&lt;li&gt;好的借口很容易被正确使
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="C++" scheme="http://zhengyi.me/tags/C/"/>
    
  </entry>
  
  <entry>
    <title>《Effective C++》读书笔记(4)</title>
    <link href="http://zhengyi.me/2016/08/15/effective-cpp-reading-notes-4/"/>
    <id>http://zhengyi.me/2016/08/15/effective-cpp-reading-notes-4/</id>
    <published>2016-08-15T13:06:32.000Z</published>
    <updated>2016-09-06T13:14:54.000Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="2-构造析构赋值运算">2 构造/析构/赋值运算</span></h2><h3><span id="条款10令-operator-返回一个-reference-to-this">条款10：令 operator= 返回一个 reference to *this</span></h3><blockquote><ul><li>令赋值（assignment）操作符返回一个 reference to *this。</li></ul></blockquote><p>有以下两个主要原因：</p><ol><li>允许连锁赋值。比如说，<code>int x, y, z; x = y = z;</code></li><li>这个协议被普遍的遵守（包括标准库中的很多类型），为了保持类的行为与其他类一致性。</li></ol><h3><span id="条款11在operator中处理自我赋值">条款11：在operator=中处理“自我赋值”</span></h3><blockquote><ul><li>确保当对象自我赋值时operator=有良好行为。其中技术包括比较“来源对象”和“目标对象”的地址、精心周到的语句顺序、以及copy-and-swap。</li><li>确定任何函数如果操作一个以上的对象，而其中多个对象是同一个对象时，其行为为仍然正确。</li></ul></blockquote><p>一个对象可能被自我赋值，比如：<br><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">Widget w[];</span><br><span class="line">// some operation</span><br><span class="line">w[i] = w[j];//w[i]和w[j]指向同一个对象</span><br></pre></td></tr></table></figure></p><p>可以在operator= 操作中做一下简单的指针比较来避免不必要的操作</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">Widget&amp; Widget::operator=(const Widget&amp; rhs) &#123;</span><br><span class="line">    if (this == &amp;rhs) return *this;</span><br><span class="line">    ...</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>当你需要在赋值操作中做一些复杂的控制逻辑，你不仅需要保证起“自我赋值安全性”还要保证“异常安全性”。这个会在条款xx中具体进行说明。</p><h3><span id="条款12复制对象时勿忘其每一个成分">条款12：复制对象时勿忘其每一个成分</span></h3><blockquote><ul><li>Copying 函数应该确保复制“对象内的所有成员变量”及“所有base class成分”</li><li>不要尝试以某个copying函数实现另一个copying函数。应该将共同机能放进第三个函数中，并由两个copying函数共同调用。</li></ul></blockquote><p>copy构造函数和copy assignment操作符我们统称为copying函数。当我们自己定义copying务必要确保所有的字段都进行了复制，同事如果有基类要保证相对应的copying函数被正确得调用。</p><p>作者认为虽然说copy构造函数和copy assignment操作符做的操作绝大多数是相同的，但是不应该尝试以某一个copying函数实现调用另一个copying函数。这样的操作并不合理。</p><h2><span id="3-资源管理">3. 资源管理</span></h2><h3><span id="条款13-以对象管理资源">条款13： 以对象管理资源</span></h3><blockquote><ul><li>为防止资源泄露，请使用RAII对象，它们在构造函数中获得资源并在析构函数中释放资源。</li><li>两个常被使用的RAII classes分别是<code>tr1::shared_ptr</code>和<code>auto_ptr</code>(C++ 11 中有<code>std::shared_ptr</code>和<code>std::auto_ptr</code>)</li></ul></blockquote><p>内存泄漏和资源泄露很多情况都是因为一个内存/资源分配在堆上，被用于一个函数内，然后在控制流离开函数的时候没有得到正确的释放。对于这种情况引起的资源泄露，可以把资源包装成对象来实现合理的释放。</p><p>“以对象管理资源” 通常也被称为”资源取得时机便是初始化时机”（<em>Resource Acquisition Is Initialization: RAII</em>）。RAII的两个核心思想：</p><ul><li>获得资源后立刻放进管理对象内。</li><li>管理对象运用析构函数确保资源得到释放。</li></ul><p>我们可以根据自己的需求定制RAII类，同时也可以使用系统提供的智能指针可以用来作为管理对象。</p><ul><li><code>auto_ptr</code> - <code>auto_ptr</code>被销毁时会自动删除它所指之物。它的缺点是，如果多个<code>auto_ptr</code>指向同一个对象，那么那个对象会被删除一次以上。另外通过copy构造函数或copy assignment操作符复制它们的时候，它们会变成null。</li><li><code>shared_ptr</code> -  <code>shared_ptr</code>是一个引用计数原理的智能指针。它能够持续追踪有多少个对象指向某个资源，而且它的复制行为也看上去正常许多。它的缺点是，它无法打破循环引用的问题。</li></ul><h3><span id="条款14在资源管理类中小心copying行为">条款14：在资源管理类中小心copying行为</span></h3><blockquote><ul><li>复制RAII对象必须一并复制它所管理的资源，所以资源的copying行为决定RAII对象的copying行为。</li><li>普遍而常见的RAII class copying行为是：禁止copying、施行引用计数法（reference counting）。不过其他行为也都可能被实现。</li></ul></blockquote><p>当我们定制RAII对象的时候，需要根据具体的需求来控制其拷贝的行为。不然可能会出现一些“不愉快”的事情。</p><p>拷贝的行为基本有下面几种：</p><ul><li><p><strong>禁止复制。</strong> 很多情况对RAII对象进行复制是不合理的，比如说一个Lock类，保存着一个锁。合理的行为是禁止这个类型的复制行为。</p></li><li><p><strong>对底层资源祭出“引用计数法”。</strong> 如果我们希望保有资源，知道它的最后一个使用者被销毁。这种情况我们就应该在内部使用一个引用计数来管理资源，我们可以用<code>shared_ptr</code>来做引用计数。</p></li><li><p><strong>复制底部资源。</strong>  拷贝时将内部的资源进行一个完整的深层拷贝。比如说，一个字符串被复制的时候，它不仅要复制指向内存中字符串的指针，同时也应该复制对应的字符串内存。</p></li><li><p><strong>转移底层资源的拥有权</strong> 在一些比较特殊的场合可能希望只有一个RAII对象指向一个资源，当被复制的时候，资源的拥有权将会进行转移。这个行为跟<code>auto_ptr</code>的行为是一样的。</p></li></ul><h3><span id="条款15在资源管理类中提供对原始资源的访问">条款15：在资源管理类中提供对原始资源的访问</span></h3><blockquote><ul><li>APIs 往往要求访问原始资源（raw resources），所以每一个RAII classes应该提供一个“取得其所管理之资源”的办法。</li><li>对原始资源的访问可能经由显式转换或隐式转换。一般而言显示转换比较安全，但是隐式转换对客户比较方便。</li></ul></blockquote><p>在一些情况下我们的需要访问资源管理类中的原始资源，这个时候我们就应该提供一个能够获得原始资源的方法。</p><p>这个看上去破坏了封装性，但是资源管理类设计的初衷是为了更好地管理资源的申请和释放，并非对资源进行完全的封装。所以提供获取原始资源的方法也还是比较合理的做法。</p><p>可以通过显式和隐式转换两种方法。</p><p><strong>显式转换</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">class Font &#123;</span><br><span class="line">public:</span><br><span class="line">    ...</span><br><span class="line">    FontHandle get() const &#123; return f; &#125;</span><br><span class="line">    ...</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>隐式转换</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">class Font &#123;</span><br><span class="line">public:</span><br><span class="line">    ...</span><br><span class="line">    operator FontHandle() const &#123; return f; &#125;</span><br><span class="line">    ...</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>虽然两种方式都可行，但个人认为显式的这种方式更好一些。因为这个可以避免很多不小心进行的转换，只有在需要的时候进行显式的调用。</p><h3><span id="条款16成对使用new和delete时要采用相同形式">条款16：成对使用new和delete时要采用相同形式</span></h3><blockquote><p>如果你在new表达式中使用[]，必须在相对应的delete表达式中也使用[]。如果你在new表达式中不使用[]，一定不要在相对应的delete表达式中使用[]</p></blockquote><h3><span id="条款17以独立语句将newed对象置入智能指针">条款17：以独立语句将newed对象置入智能指针</span></h3><blockquote><p>以独立语句将newed对象存储于智能指针内。如果不这么做，一旦异常被抛出，有可能导致难以察觉的资源泄露。</p></blockquote><p>例子：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">int priority();</span><br><span class="line">void processWidget(std::shared_ptr&lt;Widget&gt; pw, int p);</span><br><span class="line"></span><br><span class="line">// Bad</span><br><span class="line">processWidget(std::shared_ptr&lt;Widget&gt;(new Widget), priority());</span><br><span class="line"></span><br><span class="line">// Good</span><br><span class="line">std::shared_ptr&lt;Widget&gt; pw(new Widget)</span><br><span class="line">processWidget(pw, priority());</span><br></pre></td></tr></table></figure><p>为什么第一个例子有问题？因为在C++编译器生成代码的时候有可能会出现以下这种情况：</p><ol><li>执行”new Widget”</li><li>调用priority()</li><li>调用std::shared_ptr构造函数</li></ol><p>如果第二部抛出异常，那么第一步申请出来的资源还未放入智能指针内，所以没有人去释放它。于是就造成了资源泄露。</p>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;2-构造析构赋值运算&quot;&gt;2 构造/析构/赋值运算&lt;/span&gt;&lt;/h2&gt;&lt;h3&gt;&lt;span id=&quot;条款10令-operator-返回一个-reference-to-this&quot;&gt;条款10：令 operator= 返回一个 reference to *t
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="C++" scheme="http://zhengyi.me/tags/C/"/>
    
  </entry>
  
  <entry>
    <title>《Effective C++》读书笔记(3)</title>
    <link href="http://zhengyi.me/2016/07/06/effective-cpp-reading-notes-3/"/>
    <id>http://zhengyi.me/2016/07/06/effective-cpp-reading-notes-3/</id>
    <published>2016-07-06T13:13:10.000Z</published>
    <updated>2016-07-06T13:14:07.000Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="2-构造析构赋值运算">2 构造/析构/赋值运算</span></h2><h3><span id="条款05了解c默默编写并调用哪些函数">条款05：了解C++默默编写并调用哪些函数</span></h3><blockquote><p>编译器可以暗自为class创建<em>default</em>构造函数、<em>copy</em>构造函数、<em>copy assignment</em>操作符，以及析构函数。</p></blockquote><p>定义一个啥也没有的类：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">class Empty &#123; &#125;</span><br></pre></td></tr></table></figure><p>编译器有可能会帮你生成：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">class Empty &#123;</span><br><span class="line">public:</span><br><span class="line">  Empty() &#123;...&#125;     //默认构造函数</span><br><span class="line">  Empty(const Empty&amp; rhs) &#123;...&#125; //拷贝构造函数</span><br><span class="line">  ~Empty()&#123;...&#125;     //析构函数</span><br><span class="line">  Empty&amp; operator=(const Empty&amp; rhs) &#123;...&#125; // copy assignment操作符</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>是否生成这些方法取决于使用的时候是否需要，比如下面这段代码就用到了这些函数</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">Empty e1;//默认构造函数</span><br><span class="line">//析构函数</span><br><span class="line">Empty e2(e1);//拷贝构造函数</span><br><span class="line">e2 = e1;//copy assignment操作符</span><br></pre></td></tr></table></figure><h3><span id="条款06若不想使用编译器自动生成的函数就该明确拒绝">条款06：若不想使用编译器自动生成的函数，就该明确拒绝</span></h3><blockquote><ul><li>为驳回编译器自动（暗自）提供的机能，可将相应的成员函数声明为private并且不予实现。使用像<code>Uncopyable</code>这样的base class也是一种做法。</li></ul></blockquote><p>正如条款5中提到的，即使你自己没有显示定义，编译器默认会为我们创建一些函数。而在某一些条件下，这些函数所带来的行为并不是你想要的。</p><p>那么这个时候你就应该把你想要隐藏的方法声明为private并不提供任何的定义，这样任何尝试去使用的人都会收到一个链接错误。</p><p><strong><em>什么的场景下可能需要使用这种方法？</em></strong></p><ul><li>private 构造函数<br>当你希望用户不能够随意的自己去创建实例而是通过某种方法获得一个实例的时候。比如说单例模式。</li><li>private 析构函数<br>当你希望一个实例的生命周期由另一个类来管理的时候使用。比如说，你需要你的实例使用引用计数，如果不是0则不能够析构。这个时候你就需要提供比如说：Acquire，Release的方法。我觉得如果只是reference count的话，利用shared_ptr也能够实现类似的功能。<br>参考链接：<a href="https://blogs.msdn.microsoft.com/larryosterman/2005/07/01/private-destructors/" target="_blank" rel="external">Private Destructors</a></li><li>private 拷贝构造函数和copy assignment 操作符<br>当你希望一个对象是不可拷贝的时候。<br>Example: <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">Class Uncopyable &#123;</span><br><span class="line">...</span><br><span class="line">private:</span><br><span class="line">    Uncopyable(const Uncopyable&amp;);</span><br><span class="line">    ~Uncopyable&amp; operator=(const Uncopyable&amp;);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></li></ul><h3><span id="条款07为多态基类声明virtual析构函数">条款07：为多态基类声明virtual析构函数</span></h3><blockquote><ul><li>polymoriphic（带多态性质的）base classes应该声明一个virtual析构函数。如果class带有任何virtual函数，它就应该拥有一个virtual析构函数</li><li>Classes的设计目的如果不是作为base classes使用，或者不是为了具备多态性（polymorphically），就不该声明virtual析构函数。</li></ul></blockquote><p><strong><em>为什么带有多态性质的基类应该声明一个virtual析构函数？</em></strong></p><p>带有多态性质的基类意味着一个基类的指针可能存放着子类的实例。在这种情况下如果析构函数没有声明为virtual的话，delete一个基类指针不能够正确的调用到子类的析构函数。这就意味着会造成资源的泄露。</p><p>但是如果一个类设计的时候没有想让别的类继承，如果另一个类继承了，就可能会出现资源的泄露。因为C++在语言层面没有提供类似于C# seal的语法，所以没有办法杜绝这种情况。如果发现一个类的析构函数不是virtual的那么就不应该去继承它。</p><p>反过来看就更简单了，如果一个类设计的目的不是作为基类使用，也就意味着它的指针不可能指向一个子类的对象。那么声明成virtual的就没有太大必要，反而会因为virtual而增长了这个对象的内存大小。</p><h3><span id="条款08别让异常逃离析构函数">条款08：别让异常逃离析构函数</span></h3><blockquote><ul><li>析构函数绝对不要吐出异常。如果一个被析构函数调用的函数可能抛出异常，析构函数应该捕捉任何异常，然后吞下它们（不传播）或者结束程序。</li><li>如果客户需要对某个操作函数运行期间抛出的异常做出反应，那么class应该提供一个普通函数（而非在析构函数中）执行该操作。</li></ul></blockquote><p><strong><em>为什么析构函数中抛出异常不好？</em></strong></p><ol><li>析构函数被调用的地方不好控制，而且不好对其进行处理。因为任何对象都有析构函数，你不可能在任何地方对异常进行捕捉。（自己补充的）</li><li>如果析构函数中所抛出异常未处理会导致未定义行为。</li></ol><p>所以如果在析构函数中有可能执行到一些会抛异常的方法，需要对其进行捕捉。如果你认为异常可以忍受则默默吞下，记下log，否则记下log然后直接结束程序。</p><p><strong><em>有什么更好的办法？</em></strong></p><p>如果在析构函数里需要进行某个可能抛出异常的方法，那么就应该提供一个普通方法允许用户自己调用。这样子用户就有机会自己对其进行处理。</p><p>例子：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br></pre></td><td class="code"><pre><span class="line">class DBConn &#123;</span><br><span class="line">public:</span><br><span class="line">   ~DBConn() &#123;</span><br><span class="line">     db.close();   //bad, may throw exception</span><br><span class="line">   &#125;</span><br><span class="line">private:</span><br><span class="line">  DBConnection db;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">class DBConn &#123;</span><br><span class="line">public:</span><br><span class="line">   void close() &#123;</span><br><span class="line">     db.close();</span><br><span class="line">     closed = true;</span><br><span class="line">   &#125;</span><br><span class="line">   ~DBConn() &#123;</span><br><span class="line">     if (!closed) &#123;</span><br><span class="line">       try &#123;</span><br><span class="line">     db.close();   //good, catch exception and provide normal method to close</span><br><span class="line">   &#125;</span><br><span class="line">   catch (...) &#123;</span><br><span class="line">   //log</span><br><span class="line">   &#125;</span><br><span class="line">     &#125;</span><br><span class="line">   &#125;</span><br><span class="line">private:</span><br><span class="line">  DBConnection db;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;2-构造析构赋值运算&quot;&gt;2 构造/析构/赋值运算&lt;/span&gt;&lt;/h2&gt;&lt;h3&gt;&lt;span id=&quot;条款05了解c默默编写并调用哪些函数&quot;&gt;条款05：了解C++默默编写并调用哪些函数&lt;/span&gt;&lt;/h3&gt;&lt;blockquote&gt;
&lt;p&gt;编译器可以暗自
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="C++" scheme="http://zhengyi.me/tags/C/"/>
    
  </entry>
  
  <entry>
    <title>《Effective C++》读书笔记(2)</title>
    <link href="http://zhengyi.me/2016/06/28/effective-cpp-reading-notes-2/"/>
    <id>http://zhengyi.me/2016/06/28/effective-cpp-reading-notes-2/</id>
    <published>2016-06-28T13:55:42.000Z</published>
    <updated>2016-06-28T13:56:01.000Z</updated>
    
    <content type="html"><![CDATA[<h3><span id="条款4确定对象被使用前已先被初始化">条款4：确定对象被使用前已先被初始化</span></h3><blockquote><ul><li>为内置型对象进行手工初始化，因为C++不保证初始化它们。</li><li>构造函数最好使用成员初值列（member initialization list），而不是在构造函数本体内使用赋值操作（assignment）。初值列列出的成员变量，起排序次序应该和它们在class中的声明次序相同。</li><li>为了免除“跨编译单元之初始化次序”问题，请以local static对象替换non-local static对象。</li></ul></blockquote><p>内置对象指的是C++自带的类似于int，double的类型。这些类型变量如果没有进行初始化，其值是未定义的，如果对其进行读取会导致不明确的行为（undefined behavior）。所以必须要保证读取内置对象前，其被初始化过。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">int x; // bad code</span><br><span class="line">int x = 0; // good code</span><br></pre></td></tr></table></figure><p>对于非内置类型，初始化的任务则是由构造函数负责的。包括STL库里的一些类。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">std::string str;//it&apos;s ok</span><br><span class="line">std::string str = &quot;&quot;; //it&apos;s also ok</span><br><span class="line">Class1 obj;</span><br></pre></td></tr></table></figure><p><strong>类成员变量初始化 vs 赋值</strong></p><p>类的成员变量在进入构造函数之前已经已经被初始化，所以如果在构造函数内进行”初始化“的的话其实是进行赋值，会带来额外的开销。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line">class Entry &#123;</span><br><span class="line">public:</span><br><span class="line">Entry();</span><br><span class="line">private:</span><br><span class="line">std::string name;</span><br><span class="line">int value;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">Entry::Entry() &#123;</span><br><span class="line">name = &quot;default&quot;; //</span><br><span class="line">value = 0;        // not good </span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">Entry::Entry()</span><br><span class="line">  : name(&quot;default&quot;)</span><br><span class="line">  , value(0)</span><br></pre></td></tr></table></figure><p>至于作者提到的初值列中的顺序需要与class内变量声明的顺序保持一致是因为c++总是按照class内变量声明的顺序对变量，所以为了避免带来迷惑以及容易检查是否漏掉变量未初始化，最好将初值列顺序与class内变量声明顺序保持一致。</p><p><strong>non-local static 对象的初始化</strong></p><p>不同<strong>编译单元</strong>内定义的<strong>non-local static</strong>对象初始化次序未定义。</p><p><em>编译单元</em></p><p>编译单元是指产出单一目标文件（object file）的那些源码，基本上是它的源文件加上其所含入的头文件。</p><p><em>non-local static 对象</em></p><p>除了定义在函数内的static变量，其他的static变量均是non-local static对象，包括global对象、定义域namespace作用域内的对象、class内的、文件作用域内的static对象。</p><p>次序未定义会导致一个问题，就是如果你需要在一个编译单元内使用另一个编译单元的静态变量，则很有可能你在调用的时候其还没有初始化。这种情况你可以通过使用返回一个local static变量的reference的方法来得到，这个方法就是单例的常见使用场景。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">FileSystem &amp;tfs() &#123;</span><br><span class="line">   static FileSystem fs;</span><br><span class="line">   return &amp;fs</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>但这个还有一个问题就是static在多线程的情况下会出现不确定性，所以最好在程序启动时先以单线程的方式调用一遍。</p><p><strong>总之</strong>，non-local static对象最好只在一个编译单元内使用，如果需要跨编译单元使用，则使用单的方法替代。</p>]]></content>
    
    <summary type="html">


        &lt;h3&gt;&lt;span id=&quot;条款4确定对象被使用前已先被初始化&quot;&gt;条款4：确定对象被使用前已先被初始化&lt;/span&gt;&lt;/h3&gt;&lt;blockquote&gt;
&lt;ul&gt;
&lt;li&gt;为内置型对象进行手工初始化，因为C++不保证初始化它们。&lt;/li&gt;
&lt;li&gt;构造函数最好使用成员初值列（mem
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="C++" scheme="http://zhengyi.me/tags/C/"/>
    
  </entry>
  
  <entry>
    <title>《Effective C++》读书笔记(1)</title>
    <link href="http://zhengyi.me/2016/06/24/effective-cpp-reading-notes-1/"/>
    <id>http://zhengyi.me/2016/06/24/effective-cpp-reading-notes-1/</id>
    <published>2016-06-24T12:31:22.000Z</published>
    <updated>2016-06-28T13:53:05.000Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="让自己习惯c">让自己习惯C++</span></h2><h3><span id="条款01视c为一个语言联邦">条款01：视C++为一个语言联邦</span></h3><blockquote><ul><li>C++ 高效编程守则是状况而变化，取决于你使用C++的哪一个部分。</li></ul></blockquote><p>C++并不是一个单一范式编程语言，它同时支持过程形式（procedural），面向对象设计（object-oriented）、函数形式（functional）、泛型形式（generic），元编程形式（meta-programming）。</p><p>所以作者认为并不是每一个规则都是适用于所有的这些范式的，那么我们可以将C++语言分为一下几种次语言：</p><ul><li>C</li><li>Object-Oriented C++</li><li>Template C++</li><li>STL</li></ul><h3><span id="条款02尽量以constenuminline替换define">条款02：尽量以const，enum，inline替换#define</span></h3><blockquote><ul><li>对于单纯常量，最好以const对象或enums替换#define</li><li>对于形似函数的宏（macros），最好改用inline函数替换#define</li></ul></blockquote><p><strong>#define的缺点：</strong></p><ol><li>define 定义的值无法被编译器和调试器看到，出问题了很麻烦。</li><li>没有良好的封装新，不能控制作用域。</li></ol><p><strong>const</strong></p><p>使用const我可以这样声明一个常量：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">const std::string ProductName(&quot;Mango Game&quot;);</span><br><span class="line">const double Pi = 3.1415;</span><br></pre></td></tr></table></figure><p>还可以声明一个类的专属常量：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">//Header</span><br><span class="line">class Game &#123;</span><br><span class="line">private:</span><br><span class="line">static const int MaxGamePlayer ;</span><br><span class="line">...</span><br><span class="line">&#125;;</span><br><span class="line"></span><br><span class="line">//cpp file</span><br><span class="line">const int Game::MaxGamePlayer = 5;</span><br></pre></td></tr></table></figure><p><strong>enum hack</strong></p><p>如果需要编译时使用到常量就需要enum hack这个技巧，实现如下：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">class GamePlayer &#123;</span><br><span class="line">private:</span><br><span class="line">    enum &#123; NumTurns = 5&#125;</span><br><span class="line">    int scores[NumTruns];</span><br><span class="line">&#125;;</span><br></pre></td></tr></table></figure><p><strong>inline function</strong></p><p>有一些宏长得很像函数，这种宏有类型安全问题和不可预料行为两个问题。可以使用inline function来替代。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">//这个MAX宏很不好，会出现奇怪的一些问题且无法调试</span><br><span class="line">#define MAX(a,b) ((a) &gt; (b) ? (a) : (b))</span><br><span class="line"></span><br><span class="line">//Good</span><br><span class="line">template&lt;typename T&gt;</span><br><span class="line">inline T Max(const T&amp; a, const T&amp; b)</span><br><span class="line">&#123;</span><br><span class="line">    return (a &gt; b ? a : b);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3><span id="条款3尽可能使用const">条款3：尽可能使用const</span></h3><blockquote><ul><li>将某些东西声明为const可帮助编译器侦测出错误用法。const可被施加于任何作用域内的对象、函数参数、函数返回类型、成员函数本体。</li><li>编译器强制实施bitwise constness，但你编写程序时应该使用“概念上的常量性”（conceptual constness）。</li><li>当const和non-const成员函数有着实质等价的实现时，令non-const版本调用const版本可避免代码重复。</li></ul></blockquote><p>const提供一种语义上的约束，它能够约束变量使用者的行为。当它作用于针、智能指针、迭代器上的时候可以指向指针本身也可以是指针指向物。作者提出了一个识别的技巧：<em>如果关键字const出现在星号左边，表示被指物是常量；如果出现在星号右边，表示指针本身是常量。</em></p><p>例子：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"></span><br><span class="line">char greeting[] = &quot;Hello&quot;</span><br><span class="line">char *p = greeting;//non const point, const data</span><br><span class="line">const char * p = greeting;//non const point, const data </span><br><span class="line">char const * p = greeting;//non const point, const data</span><br><span class="line">char * const p = greeting;//const point, non const data</span><br><span class="line">const char* const p = greeting; //const point, const data</span><br><span class="line"></span><br><span class="line">const std::vector&lt;int&gt;::iterator it;// --&gt; T * const p</span><br><span class="line">*it = 10; //合法</span><br><span class="line">it++;//不合法</span><br><span class="line">std::vector&lt;int&gt;::const_iterator it;// --&gt; const T * p</span><br><span class="line">it = 10;//不合法</span><br><span class="line">it++;//合法</span><br><span class="line"></span><br><span class="line">std::shared&lt;T&gt; p1;</span><br><span class="line">std::shared&lt;const T&gt; p;// --&gt; const T *p</span><br><span class="line">p = p1;//合法</span><br><span class="line">*p.get() = x;//不合法</span><br><span class="line">const std::shared&lt;T&gt; p; // --&gt; T* const p</span><br><span class="line">p = p1;//不合法</span><br><span class="line">*p.get() = x;//合法</span><br></pre></td></tr></table></figure><p>有点头晕，我有一个不是很恰当地记忆方法。可以把<code>const</code>看成修饰它右边所有内容的，以<code>const char* p</code>为例，把<code>p</code>看成一个指针，而<code>*p</code>则是数据，所以<code>const</code>是修饰数据的。而<code>char * const p</code>中，<code>const</code>右边只有<code>p</code>，所以它只是限制指针本身的。</p><h4><span id="bitwise-constness-vs-logical-constness">bitwise constness vs logical constness</span></h4><p>当限制一个成员函数为const，编译器会执行bitwise constness，即检查函数内部是否修改了类的成员变量。但是写代码的时候应该注意逻辑上的常量限制，比如说一个你返回了一个指向内部变量的指针，这个函数虽然符合编译器的const限制但却不是很好的一个写法。</p><p>[to be continued]</p>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;让自己习惯c&quot;&gt;让自己习惯C++&lt;/span&gt;&lt;/h2&gt;&lt;h3&gt;&lt;span id=&quot;条款01视c为一个语言联邦&quot;&gt;条款01：视C++为一个语言联邦&lt;/span&gt;&lt;/h3&gt;&lt;blockquote&gt;
&lt;ul&gt;
&lt;li&gt;C++ 高效编程守则是状况而变化，取决
      
    
    </summary>
    
      <category term="编程语言" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
    
      <category term="编程语言" scheme="http://zhengyi.me/tags/%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80/"/>
    
      <category term="C++" scheme="http://zhengyi.me/tags/C/"/>
    
  </entry>
  
  <entry>
    <title>Mac 命令学习 - grep</title>
    <link href="http://zhengyi.me/2016/06/06/learning-shell-grep/"/>
    <id>http://zhengyi.me/2016/06/06/learning-shell-grep/</id>
    <published>2016-06-06T13:45:02.000Z</published>
    <updated>2016-06-06T13:58:37.000Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="背景知识">背景知识</span></h2><p>grep是linux中常用的文本处理的工具，与之类似的工具有sed和awk，它们分别适用于不同的场景。同时要想很好的使用grep等文本处理工具，需要对正则表达式有一定的了解。</p><h3><span id="grep-vs-sed-vs-awk">grep vs sed vs awk</span></h3><p>grep主要用于对文本、文件进行搜索，查找出符合要求的字符串并输出相关的内容。</p><p>sed和awk则是更强大文本处理工具，适用于更复杂的场景。sed是一个基于字符流的处理工具（stream editor），不仅可以查找文字还可以对文本进行操作，比如说修改、删除、插入等。awk则是更加强大的工具，它本身是一个完整的编程语言，可用于对数据的提取处理然后生成一些报表，主要针对类csv格式的文件。</p><h3><span id="正则表达式">正则表达式</span></h3><p>to be written</p><h3><span id="grep的种类">grep的种类</span></h3><ul><li><strong>grep</strong> | grep使用简单的模式和正则表达式进行搜索。</li><li><strong>egrep</strong> | egrep使用拓展版的正则表达式，包含更多的正则表达式功能。</li><li><strong>fgrep</strong> | fgrep是加速版的grep，主要适用于简单的模式匹配。</li><li><strong>zgrep, zegrep, zfgrep</strong> | 与grep, egrep, fgrep 效果相同，只是可以接受一个由compress或gzip压缩出来的压缩包进行搜索。在现在的操作系统中，多种的grep使用的是同一个binary，而不是不同的binary。比如说<code>grep -E</code>其实等效于egrep，<code>grep -F</code>等效于fgrep。</li></ul><h2><span id="常用参数">常用参数</span></h2><p><code>-A num, --after-context=num</code> - 打印出找到的匹配行后num行。这个跟<code>-B</code>，<code>-C</code>类似功能，主要用于查看上下文。</p><p><code>-B num, --before-context=num</code> - 打印出找到的匹配行前num行。</p><p><code>-C[num, --context=num]</code> - 打印出找到的匹配行前后num行，相当于<code>-A num -B num</code>。</p><p><code>-c, --count</code> - 统计出匹配的总行数，同一行有两个匹配也只算一行。</p><p><code>--colour=[when, --color=[when]]</code> - 将匹配的字符标记为彩色，when可以是’never’，‘auto’或’always’。</p><p><code>-e pattern, --regexp=pattern</code> - 制定在搜索中使用的匹配模式，多用于指定多个匹配模式的情况。</p><p><code>-H</code> - 在每一行前面打印出匹配的文件名，在多个文件的情况下这个是默认选项。</p><p><code>-h</code> - 在多个文件的情况下不打印出匹配的文件名。</p><p><code>-n</code> - 打印出匹配所在行的行数。</p><p><code>-i, --ignore-case</code> - 查找时忽略大小写。</p><p><code>-R, -r, --recursive</code> - 递归的去查找子目录下的文件。</p><p><code>-v, --invert-match</code> - 打印出不匹配的行。</p><p><code>-w, --word-regexp</code> - 只匹配整个单词。</p><h2><span id="案例学习">案例学习</span></h2><p>实验文件，随便找了一个莎士比亚的十四行诗：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line">$ cat demofile</span><br><span class="line">sonnet 18</span><br><span class="line"></span><br><span class="line">Shall I compare thee to a summer&apos;s day? </span><br><span class="line">Thou art more lovely and more temperate: </span><br><span class="line">Rough winds do shake the darling buds of May, </span><br><span class="line">And summer&apos;s lease hath all too short a date: </span><br><span class="line"></span><br><span class="line">Sometime too hot the eye of heaven shines, </span><br><span class="line">And often is his gold complexion dimm&apos;d; </span><br><span class="line">And every fair from fair sometime declines, </span><br><span class="line">By chance or nature&apos;s changing course untrimm&apos;d </span><br><span class="line"></span><br><span class="line">But thy eternal summer shall not fade </span><br><span class="line">Nor lose possession of that fair thou owest; </span><br><span class="line">Nor shall Death brag thou wander&apos;st in his shade, </span><br><span class="line">When in eternal lines to time thou growest: </span><br><span class="line"></span><br><span class="line">So long as men can breathe or eyes can see, </span><br><span class="line">So long lives this and this gives life to thee.</span><br><span class="line">$ cp demofile demofile2</span><br></pre></td></tr></table></figure><ol><li><p>在文件中搜索某个字符串。</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">$ grep &quot;and&quot; demofile</span><br><span class="line">Thou art more lovely and more temperate: </span><br><span class="line">Nor shall Death brag thou wander&apos;st in his shade, </span><br><span class="line">So long lives this and this gives life to thee.</span><br></pre></td></tr></table></figure></li><li><p>匹配整个单词。</p><p> 上面的例子中搜索and这个字符串匹配了wander这个单词，如果我们只想搜and这个单词可以使用<code>-w</code>参数。</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">$ grep -w &quot;and&quot; demofile</span><br><span class="line">Thou art more lovely and more temperate: </span><br><span class="line">So long lives this and this gives life to thee.</span><br></pre></td></tr></table></figure></li><li><p>忽略大小写</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">$ grep -i -w &quot;and&quot; demofile</span><br><span class="line">Thou art more lovely and more temperate: </span><br><span class="line">And summer&apos;s lease hath all too short a date: </span><br><span class="line">And often is his gold complexion dimm&apos;d; </span><br><span class="line">And every fair from fair sometime declines, </span><br><span class="line">So long lives this and this gives life to thee.</span><br></pre></td></tr></table></figure></li><li><p>使用正则表达式</p><p> 只要把匹配的字符串换成需要的正则表达式即可。比如说需要搜索以And开头的行。</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">$ grep &quot;^And&quot; demofile</span><br><span class="line">And summer&apos;s lease hath all too short a date: </span><br><span class="line">And often is his gold complexion dimm&apos;d; </span><br><span class="line">And every fair from fair sometime declines,</span><br></pre></td></tr></table></figure></li><li><p>显示上下文</p><p> 有时候搜出来需要看看上下文，可以利用上面提到的<code>-B</code>，<code>-A</code>和<code>-C</code>来实现。</p><p> 比如想要找出包含”nature”的句子并打印出上下两行。</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">$ grep -C2 &quot;nature&quot; demofile</span><br><span class="line">And often is his gold complexion dimm&apos;d; </span><br><span class="line">And every fair from fair sometime declines, </span><br><span class="line">By chance or nature&apos;s changing course untrimm&apos;d </span><br><span class="line"></span><br><span class="line">But thy eternal summer shall not fade</span><br></pre></td></tr></table></figure></li><li><p>统计出匹配的总行数</p><p> 比如说想要统计出现”to”的行数</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">$ grep -c &quot;to&quot; demofile</span><br><span class="line">5</span><br></pre></td></tr></table></figure><p>如果想要统计出现的总次数的话，grep本身没有办法满足这个需求，需要使用sed或awk来实现。或者结合wc来实现。</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">$ grep -o &quot;to&quot; demofile| wc -l</span><br><span class="line">       5</span><br></pre></td></tr></table></figure></li><li><p>高亮匹配文字</p><p> 高亮匹配文字可以让肉眼可以第一时间的看到匹配结果，利用–color=auto/always来实现。此处nature高亮状。</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">$ grep --color=auto &quot;nature&quot; demofile</span><br><span class="line">By chance or nature&apos;s changing course untrimm&apos;d</span><br></pre></td></tr></table></figure></li><li><p>简单匹配多个模式</p><p> 查找多个字符串可以使用<code>|</code>字符来进行简单的匹配。比如说<code>&quot;heaven|nature&quot;</code>表示匹配heaven或者nature。因为这个是正则表达式的拓展部分，所以需要使用<code>-E</code>或者egrep。</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">$ grep -E &quot;heaven|nature&quot; demofile</span><br><span class="line">Sometime too hot the eye of heaven shines, </span><br><span class="line">By chance or nature&apos;s changing course untrimm&apos;d</span><br></pre></td></tr></table></figure></li><li><p>复杂匹配多个模式</p><p> 需要找出符合多个模式的匹配。比如说，找出以”When”开头或者包含”fade”的行。</p> <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">$ grep -e &quot;^When&quot; -e &quot;fade&quot; demofile</span><br><span class="line">But thy eternal summer shall not fade </span><br><span class="line">When in eternal lines to time thou growest:</span><br></pre></td></tr></table></figure></li><li><p>找出不满足条件的匹配</p><p>在一些情况下我们需要找出不满足某个条件的行，这个时候就可以用<code>-v</code>来实现了。</p><p>比如说想找出首字母不是大写字母的行。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">$ grep -v &quot;^[A-Z]&quot; demofile</span><br><span class="line">sonnet 18</span><br></pre></td></tr></table></figure></li><li><p>打印出匹配所在行的行数</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">$ grep -e &quot;^When&quot; -e &quot;fade&quot; -n demofile</span><br><span class="line">13:But thy eternal summer shall not fade </span><br><span class="line">16:When in eternal lines to time thou growest:</span><br></pre></td></tr></table></figure></li><li><p>打印出文件名</p><p>进行多个文件搜索的情况下，默认会打印出文件名。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">$ grep -e &quot;^When&quot; -e &quot;fade&quot; demofile demofile2</span><br><span class="line">demofile:But thy eternal summer shall not fade </span><br><span class="line">demofile:When in eternal lines to time thou growest: </span><br><span class="line">demofile2:But thy eternal summer shall not fade </span><br><span class="line">demofile2:When in eternal lines to time thou growest:</span><br></pre></td></tr></table></figure></li></ol><p>[EOF]</p>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;背景知识&quot;&gt;背景知识&lt;/span&gt;&lt;/h2&gt;&lt;p&gt;grep是linux中常用的文本处理的工具，与之类似的工具有sed和awk，它们分别适用于不同的场景。同时要想很好的使用grep等文本处理工具，需要对正则表达式有一定的了解。&lt;/p&gt;
&lt;h3&gt;&lt;span
      
    
    </summary>
    
      <category term="编程工具" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E5%B7%A5%E5%85%B7/"/>
    
    
      <category term="shell" scheme="http://zhengyi.me/tags/shell/"/>
    
      <category term="mac" scheme="http://zhengyi.me/tags/mac/"/>
    
      <category term="terminal" scheme="http://zhengyi.me/tags/terminal/"/>
    
  </entry>
  
  <entry>
    <title>Mac 命令学习 - mv, rm, mkdir</title>
    <link href="http://zhengyi.me/2016/06/03/learning-shell-rm-mv-mkdir/"/>
    <id>http://zhengyi.me/2016/06/03/learning-shell-rm-mv-mkdir/</id>
    <published>2016-06-03T14:25:48.000Z</published>
    <updated>2016-06-03T14:27:57.000Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="mv-move">mv （move）</span></h2><p>mv是用于移动文件的命令，mac下没有重命名的命令，所以很多时候mv也用来重命名文件。</p><p><strong>常用参数</strong></p><p><code>-f</code> - 强制覆盖不提醒<br><code>-i</code> - 覆盖目标文件前提醒<br><code>-n</code> - 不覆盖目标文件</p><p><strong>将n个文件移动到某个目录下</strong></p><p><code>mv file1 file2 file3 dir</code></p><p>如果目录不存在，会报错</p><p><strong>重命名/移动文件</strong></p><p><code>mv file1 file2</code></p><p>如果file2不存在则重命名为file2，如果存在则覆盖</p><p><strong>移动目录</strong></p><p><code>mv dir1 dir2</code></p><p>将dir1移动到dir2目录下，如果dir2不存在则是一个重命名的效果</p><h2><span id="rmremove">rm（remove）</span></h2><p>此命令用于删除文件和目录，与通配符结合使用时破坏很大，稍有不慎将酿成大错后悔莫及。</p><p>普通的删除只是将文件从文件系统中移除，磁盘上的那块空间并不会去动它。所以如果误删除的话，通过某一些还原工具是有可能找回来的。</p><blockquote><p>Linux并没有撤销删除命令，一旦你用<code>rm</code>命令将某个文件删除，你将很难恢复（mac可以通过特殊的数据还原工具）。如果错误的使用<code>rm</code>，特别是跟通配符结合使用的时候，将有可能造成极大的危害。<br>在<code>rm</code>中使用通配符之前，有一个有用的小诀窍：先将你的通配符用<code>ls</code>命令试试看，看一下所影响的文件。当你用<code>ls</code>测试过没问题以后，你可以直接把<code>ls</code>特换成<code>rm</code>。<sup><strong>[1]</strong></sup></p></blockquote><h3><span id="基本用法">基本用法</span></h3><p><code>rm [-dfiPRrvW] file ...</code></p><p><code>-f</code> - 强制删除，没有提示<br><code>-i</code> - 删除某个文件前请求确认<br><code>-P</code> - 粉碎性删除。删除文件前重新复写整个文件，往文件里不停写入<code>0xff</code>和<code>0x00</code>。这样删除的文件无法恢复。<br><code>-R</code> - 递归删除。如果指定的文件为目录，则删除目录下所有的文件及其子目录。</p><h2><span id="rmdirremove-directory">rmdir（remove directory）</span></h2><p>不要被这货的名字迷惑了，这个命令唯一的用途就是删除一个空白的文件夹。如果文件夹非空还是要用<code>rm -r</code>来删除，不知道它存在的意义是什么。</p><h2><span id="mkdirmake-directory">mkdir（make directory）</span></h2><p>顾名思义，创建文件夹使用。</p><h3><span id="基本用法">基本用法</span></h3><p><code>-p</code> 创建中间目录，比如<code>mkdir /path/with/many/layer</code>会帮你吧layer之前的所有层级的目录都创建出来。<br><code>-m</code> 制定文件夹的权限，详见chmod。</p><h2><span id="参考资料">参考资料</span></h2><ol><li><a href="http://linuxcommand.org/lc3_lts0050.php" target="_blank" rel="external">Manipulating Files</a></li></ol><p><strong>阅读更多</strong></p><a href="/2016/05/23/learning-shell-in-mac/" title="Mac/Linux 命令学习">Mac/Linux 命令学习</a>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;mv-move&quot;&gt;mv （move）&lt;/span&gt;&lt;/h2&gt;&lt;p&gt;mv是用于移动文件的命令，mac下没有重命名的命令，所以很多时候mv也用来重命名文件。&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;常用参数&lt;/strong&gt;&lt;/p&gt;
&lt;p&gt;&lt;code&gt;-f&lt;/cod
      
    
    </summary>
    
      <category term="编程工具" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E5%B7%A5%E5%85%B7/"/>
    
    
      <category term="shell" scheme="http://zhengyi.me/tags/shell/"/>
    
      <category term="mac" scheme="http://zhengyi.me/tags/mac/"/>
    
      <category term="terminal" scheme="http://zhengyi.me/tags/terminal/"/>
    
  </entry>
  
  <entry>
    <title>Mac 命令学习 - chflags</title>
    <link href="http://zhengyi.me/2016/06/02/learning-shell-chflags/"/>
    <id>http://zhengyi.me/2016/06/02/learning-shell-chflags/</id>
    <published>2016-06-02T15:20:25.000Z</published>
    <updated>2016-06-02T15:32:38.000Z</updated>
    
    <content type="html"><![CDATA[<h2><span id="背景知识">背景知识</span></h2><p>在<a href="/2016/05/24/learning-shell-in-mac-ls/" title="ls">ls</a>命令中有出现过一个<code>-O</code>的选项，即列出文件的file flag。这个File flag所为何物？</p><p>File flag是在BSD Unix中的概念，跟Linux系统中的attr是差不多的一个概念，是文件的一些标志位来存放文件的某些属性。chflags就是来修改这个file flag的。这个文件属性是跟文件系统相关的，所以这个命令在不同的文件系统上的支持程度不一样，体现在某一些flag在一些特定的文件系统上没有。<sup>[1]</sup></p><p>所有的属性都可以被超级管理员修改，有一些可以被文件的所有者修改。以下列出比较常用的几个属性<sup>[1]</sup>。</p><table><thead><tr><th>属性</th><th>ls中显示</th><th>chflags中使用</th><th>文件所有者能否修改？</th><th>详述</th></tr></thead><tbody><tr><td>隐藏</td><td>hidden</td><td>hidden</td><td>能</td><td>设置以后在GUI上看不到，ls依然可以看到d</td></tr><tr><td>系统级只能添加</td><td>sappnd</td><td>sappnd, sappend</td><td>否</td><td>设置以后此文件不能够截断或者复写(overwrite)，只能通过append模式添加内容</td></tr><tr><td>用户级只能添加</td><td>uappnd</td><td>uappnd, uappend</td><td>能</td><td>设置以后此文件不能够截断或者复写(overwrite)，只能通过append模式添加内容</td></tr><tr><td>系统级只读</td><td>schg</td><td>schg, schange, simmutable</td><td>否</td><td>不能够重命名、移动、删除、更改内容</td></tr><tr><td>用户级只读</td><td>uchg</td><td>uchg, uchange, uimmutable</td><td>能</td><td>不能够更改内容</td></tr></tbody></table><h2><span id="基本用法">基本用法</span></h2><p><code>chflags [-fhv] [-R [-H | -L | -P]] flags file</code></p><h2><span id="常用参数">常用参数</span></h2><p><code>-R</code> 递归修改参数中文件夹下面的所有文件和文件夹的属性</p><h2><span id="具体案例">具体案例</span></h2><p><strong>为一个文件添加一个属性</strong></p><p><code>chflags uchg file</code></p><p><strong>为一个文件删除一个属性</strong></p><p><code>chflags nouchg file</code></p><p>在属性名字前面添加no就可以将属性删除，如果这个属性本身已no开头（比如nodump）则去掉no。</p><p><strong>将文件夹及其文件夹下所有文件属性进行修改</strong></p><p><code>chflags -R uchg directory</code></p><h2><span id="参考资料">参考资料</span></h2><ol><li><a href="https://en.wikipedia.org/wiki/Chattr" target="_blank" rel="external">chattr - Wikipedia</a></li></ol>]]></content>
    
    <summary type="html">


        &lt;h2&gt;&lt;span id=&quot;背景知识&quot;&gt;背景知识&lt;/span&gt;&lt;/h2&gt;&lt;p&gt;在&lt;a href=&quot;/2016/05/24/learning-shell-in-mac-ls/&quot; title=&quot;ls&quot;&gt;ls&lt;/a&gt;命令中有出现过一个&lt;code&gt;-O&lt;/code&gt;的选项，即列出文件的f
      
    
    </summary>
    
      <category term="编程工具" scheme="http://zhengyi.me/categories/%E7%BC%96%E7%A8%8B%E5%B7%A5%E5%85%B7/"/>
    
    
      <category term="shell" scheme="http://zhengyi.me/tags/shell/"/>
    
      <category term="mac" scheme="http://zhengyi.me/tags/mac/"/>
    
      <category term="terminal" scheme="http://zhengyi.me/tags/terminal/"/>
    
  </entry>
  
</feed>